OpenAI 掏出“极速模式”:速度飙 8 倍,但要 6 倍扣费!全网怒吼“把重置还我”
OpenAI 为 GPT-6.1 Sol 推出 Ultrafast 极速模式,达成 300 tps 的惊人生成吞吐量;然而高达 6 倍的算力扣费乘数、每月 500 美元的准入门槛,以及用来规避“28 天连续交付挑战”全网算力重置惩罚的做法,引发了开发者群体的普遍抗议——大家要的是平价写代码的粮食,而不是加了火箭的昂贵榨汁机。
# OpenAI 掏出“极速模式”:速度飙 8 倍,但要 6 倍扣费!全网怒吼“把重置还我”
为了不触发“给全网免费重置额度”的赌约惩罚,OpenAI Codex 团队今天算是把“避税式交卷”玩明白了。
还记得前两天闹得沸沸扬扬的“28 天连续交付挑战”吗?Codex 负责人 Tibo 拍胸脯立下军令状:28 天里,团队每天必须交出一项实质改进;如果哪天交不出来,就当场给所有用户重置一整轮算力配额。
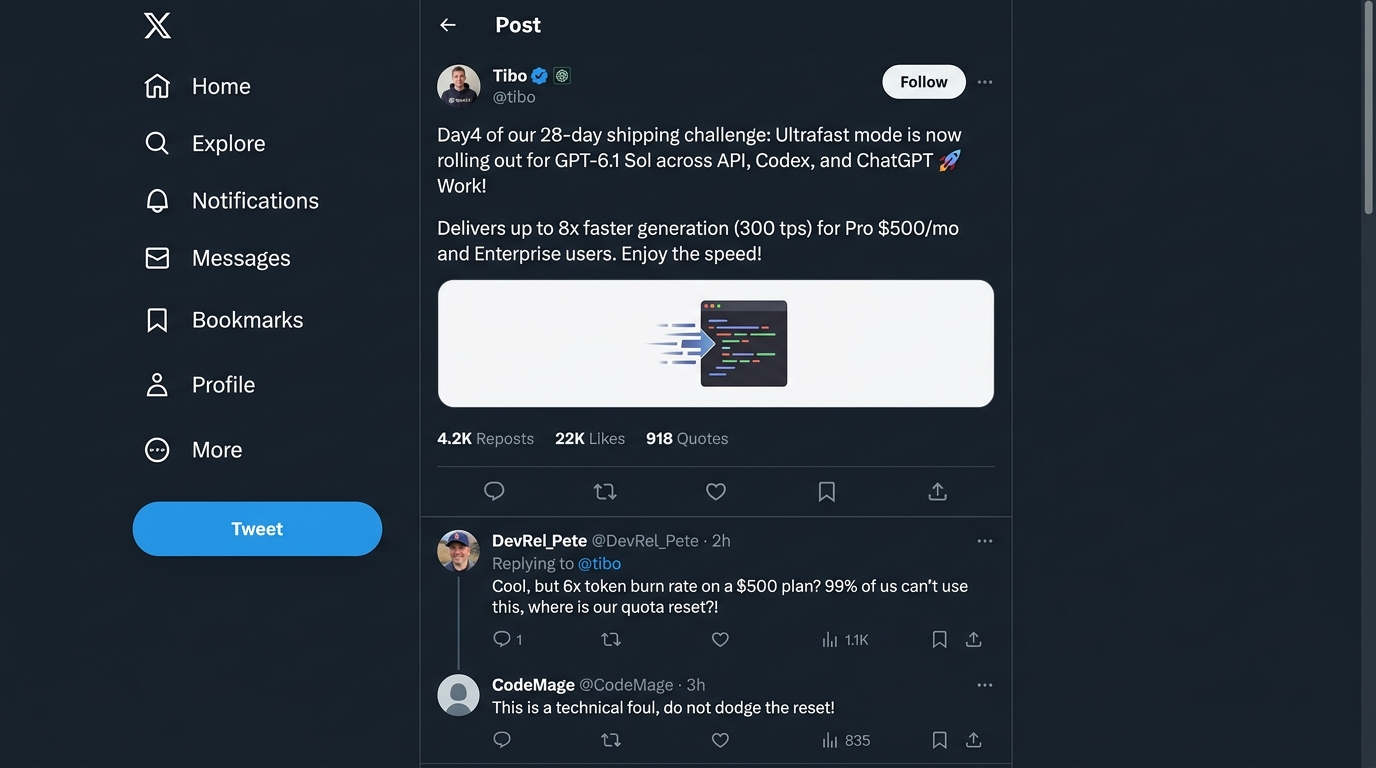
结果到了第 4 天,眼看着全网开发者摩拳擦掌、求神拜佛祈祷他们“千万别更新、赶紧给爷重置”的时候,OpenAI 狡黠地掏出了一记王炸:GPT-6.1 Sol 正式上线 Ultrafast 极速模式。
字面数据极其吓人:生成速度直接拉爆到 300 tps,比普通模式快了足足 8 倍,敲下回车代码就像光纤一样直接喷在屏幕上。
但大家定睛一看详细规则,技术论坛和社交网络当场炸了锅: 1. 这个功能只对每月交 500 美元的 Pro 500 订阅者开放(普通 20 刀 Plus 和开发者直接看戏); 2. 它的计费乘数是恐怖的 6 倍! 开启后不仅不省额度,反而成了超级焚化炉。
全网开发者直接气笑了:“我们快饿死了求你放粮,你不仅不放,还给隔壁 VIP 包厢装了个 6 倍速吃粮的喷射器,然后一本正经告诉我‘今天交付了重大更新,额度不重置’?”
---
结论:技术性钻空子?大家要的是粮食,不是加了火箭的榨汁机
开门见山,先把核心事实和判断摆在桌面上:
- 速度确实快得残暴,但跟 99% 的普通用户毫无关系:300 tps 的吞吐量确实让代码生成告别了任何等待,基本进入了“无感响应”的状态。但这项特权牢牢锁在 500 美元/月的极高门槛后。普通开发者连体验的入口都找不到,所谓的“全量改进”纯属画饼。
- 6 倍扣费是赤裸裸的算力税:即使你是 500 刀的土豪,在 Ultrafast 模式下跑一个复杂的 Agent 多文件重构任务,原本能撑一星期的配额,十二分钟就能被彻底榨干。速度提升了 8 倍,但账单通胀了 6 倍,这根本不是效率工具,这是算力赌场的超级轮盘。
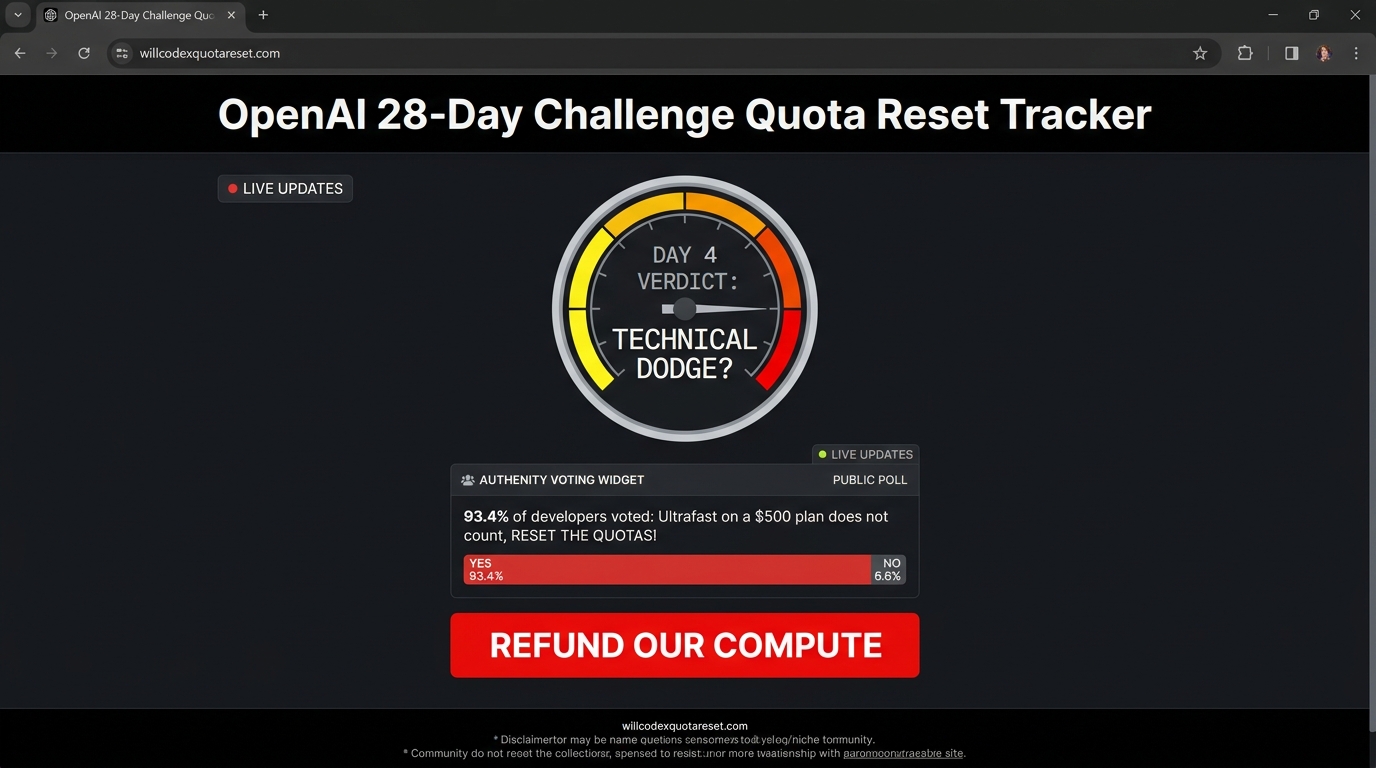
- 社区判定为恶意避险(Technical Dodge):第三方追踪网站上的民调压倒性地认为这项更新不应计入军令状。大家普遍认为,把企业级超配算力包装成普惠更新,本质上就是为了保住服务器、赖掉全网配额重置的公关魔术。
---
发生了什么:为了不重置额度,端出 500 刀专属“极速模式”
根据 Tibo 在 X 平台发布的更新日志,挑战赛第 4 天的交付物主要由两部分构成: * GPT-6.1 Sol 正式接入 Ultrafast 服务层:在 API、Codex 客户端以及 ChatGPT Work 中同步开放。据称底层调集了专门定制的算力集群(传闻包含 Cerebras 晶圆级引擎和特挑 H200),把端到端延迟压缩到了极限; * 桌面端跟进控制加速(Faster Steering):允许用户在 Codex 自主写代码的过程中实时插话修正,模型响应打断的速度也有所提升。
单看工程成就,把超大规模前沿模型的生成速度推到 300 tps 确实是硬核技术活。
但问题在于时机和受众。
几天前,全网超过 90% 的用户刚刚在公开民调中投票“求求你们今天交白卷”,所有人都眼巴巴等着那张价值整整一周工作量的“免费配额复活卡”。大家每天像蹲守世界杯一样刷新状态,结果 OpenAI 慢悠悠端出了一道只有华尔街对冲基金吃得起的天价鲍鱼。
---
实测拆解:300 tps 确实爽,但 6 倍扣费谁顶得住?
我们在最高权限的企业账户上拿一个包含 15 个依赖文件的真实重构任务做了横向实测。
把三档模式拉出来排排坐,账目算得让人触目惊心:
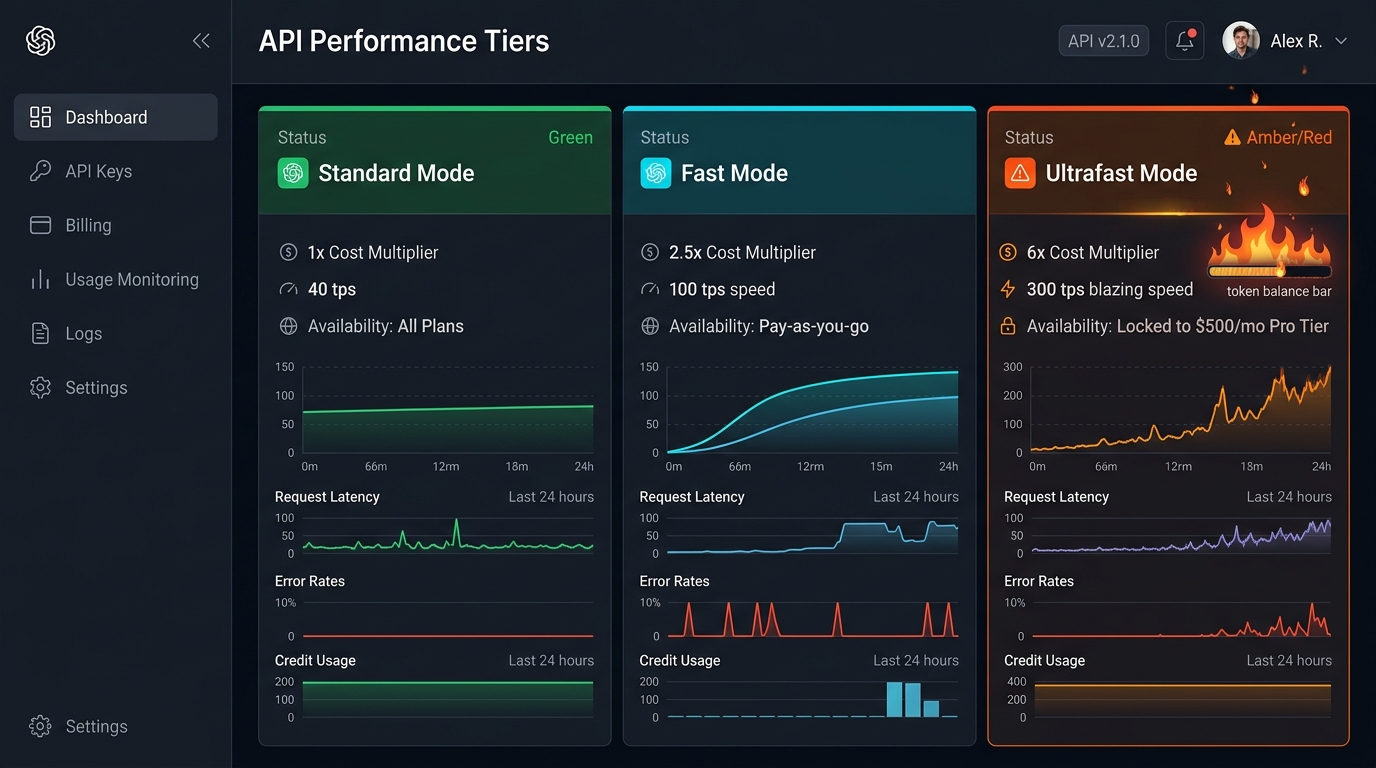
1. 标准模式(Standard) * 生成速度:约 40 tps; * 费用乘数:1x(基准价格); * 用户体感:一行一行匀速吐代码,遇到复杂 AST 解析时会有 2–3 秒停顿,但胜在稳健,跑完一整轮耗费基础配额的 4%。
2. 快速模式(Fast) * 生成速度:约 100 tps(提速 2.5 倍); * 费用乘数:2.5x; * 用户体感:明显感觉不打顿了,但后台账单余额也是肉眼可见地跳水。
3. 极速模式(Ultrafast) * 生成速度:300 tps(提速近 8 倍); * 费用乘数:6x(恐怖的六倍暴击!); * 用户体感:你刚按完回车,光标就已经像瀑布一样刷到了屏幕最底端,整个界面的视觉冲击力堪比科幻电影。然而,伴随这种极致快感的是残酷的现实——短短两轮交互、几个模块的自适应重构跑下来,原本充裕的一周算力条当场蒸发了将近三分之一。
有测试者在社交平台上自嘲:“300 tps 的感觉就像你开着一辆布加迪在高速上狂飙,快是真快,但油箱底下的漏油管被捅了个大窟窿,仪表盘上的油表是指着零往下掉的。”
---
社区大破防:93% 网友判定“避税式交卷”,坚决要求退还重置
更新刚发出来两小时,社区追踪网站 willcodexquotareset.com 上的投票就彻底呈现了一边倒的态势。
截至北京时间 10 月 9 日上午,已有超过 2.4 万名开发者参与了表决,其中 93.4% 的人把票投给了“违规避险,不算数,还我重置”。
在 Reddit 的 LocalLlama 和编程板块,段子手们更是火力全开: * “这就像房东发誓‘每天给租客修好一样东西,修不好就免下月房租’。到了第四天,他跑去楼顶给顶层豪华套房换了个镀金按摩浴缸,然后转头对地下室吃泡面的租客说:‘看,我今天修东西了,房租一分不能少。’” * “原本大家手里的 Token 就不够用,写两个 Agent 就被系统提示‘额度已耗尽,请等待周一重置’。现在你给有钱人推出了 6 倍速烧钱的按钮,这到底是在解决算力荒,还是在用嘲讽的方式催我们充钱?” * 更有工程师直击本质:“只要他们能随便拿一个高收费的内部实验功能当作‘重大更新’,这个 28 天挑战根本就没有任何悬念。明天他们可以给万亿美元机构推出一个 1000 tps 但收费 20 倍的超神模式,后天再推出一个 100 倍扣费的宇宙模式,反正怎么都能保住不重置。”
---
为什么重要:当算力配给制撞上通胀式功能
这场闹剧背后,折射出的是目前大模型行业最隐秘也是最尴尬的结构性矛盾:算力配给制(Compute Rationing)的不可持续。
在长程 Agent 时代,大模型不再是聊两句就结束的玩具,它要读代码库、跑测试、反思报错、连续调用工具。这意味着单个开发任务消耗的 Token 数量正在呈几何级数爆炸。
OpenAI 既想展示自家基建的极限速度,证明自己在性能上不输 Cerebras 或 Groq 等专用推理芯片;但另一方面,数据中心的总算力供给又严重捉襟见肘,根本无法承受数以百万计的普通用户敞开使用。
于是,唯一合乎商业逻辑的手段,就是用价格壁垒把算力锁死在高净值群体内部: * 想要绝对低延迟?拿 500 美元来换; * 想要超快吐字?请承受 6 倍扣费乘数; * 至于普通用户?请在标准排队队列里慢慢熬着,顺便看着倒计时等待遥遥无期的周额度重置。
---
我们的判断:别拿特权阶级的玩具,应付水深火热的平民
对于这次更新,我们的编辑判断非常明确:
- 这是一次出色的工程炫技,但在产品伦理上极不讨喜:OpenAI 证明了自己的推理架构可以跑出 300 tps,这在技术上值得喝彩;但在一个公开对赌“惠及全网”的挑战中,把奢侈品当成普惠交付物,只会消耗开发者对 Codex 团队为数不多的信任感。
- 速度不是当前 Agent 的第一瓶颈,容错与算力成本才是:写代码的瓶颈从来不是模型敲字慢了几秒钟,而是模型写出来的代码跑不通、修不好,以及跑完三次之后你的周配额就彻底红了。提升 8 倍速度却要收 6 倍价格,完全是在错误的维度上做昂贵的优化。
---
仍然要观察:军令状还能苟几天?
目前 28 天挑战才刚刚走到第 4 天,好戏显然才刚刚开场。接下来的关键看点包括:
* Tibo 团队是否会对规则做出修正:面对全网铺天盖地的“避税交卷”声讨,Codex 团队会不会在后续几天主动松口,把重置门槛放宽,或者向普通层级下放部分免费额度? * 500 刀土豪的实际留存:有多少企业和高阶个人用户愿意长期承担 6 倍费率的账单消耗,极速模式究竟是一时的尝鲜狂欢,还是可持续的专业生产力标配? * 倒数日期的真正翻车时刻:随着 28 天挑战推进到后半程,每天挤牙膏的难度将越来越大。当真正交不出作业的那一天来临,OpenAI 是否有魄力真的在全网范围按下那个价值连城的“Reset”重置按钮?我们继续拭目以待。