同天发布跑分并列?实测 MiMo-V2.6 对撞 Grok 4.7:小米开源背刺马斯克,大模型价格战被彻底打穿
同天发布的 MiMo-V2.6 与 Grok 4.7 在综合智力与编程基准上双双打平 46 分档,但小米以 1/20 的 API 成本、全开源权重与无注水 Token 消耗,把大模型价格底线彻底击穿。
# 同天发布跑分并列?实测 MiMo-V2.6 对撞 Grok 4.7:小米开源背刺马斯克,大模型价格战被彻底打穿
2026 年 9 月 22 日,全球大模型竞技场上演了极具戏剧性的一幕。马斯克的 xAI 调动庞大的 Colossus 超级计算集群,正式推送新一代旗舰推理与编程模型 Grok 4.7,打出每百万 Token 输入 2 美元、输出 6 美元的“颠覆性低价”,试图在代码补全与复杂工程重构赛道对 OpenAI 展开降维打击;几乎就在同一时刻,前 DeepSeek 核心算法专家罗福莉带队的小米 AI 实验室,在毫无预告的情况下直接向全网公开开源新一代旗舰模型家族 MiMo-V2.6(涵盖 Pro、Flash 以及 Pro-UltraSpeed)。在国际公认的独立评测机构 Artificial Analysis 智能指数以及 CursorBench 4.0 编程基准测试中,两者竟以 46.32 与 46.0 的高分近乎打成平手,双双登顶全球第一梯队。但真正引爆全球开发者讨论的不是并列的分数,而是一笔残酷的经济账:小米不仅把 API 单价压到了海外闭源模型的二十分之一甚至六十分之一,更全量开源权重支持本地离线运行;实测更揭示,Grok 4.7 因输出严重过度冗长垫字,导致真实调用账单被隐形吹胀 3 到 4 倍。一场关于算力神话、开源颠覆与真实商业性价比的大对撞,在今天彻底拉开大幕。
---
核心结论:并列第一背后的性价比断层
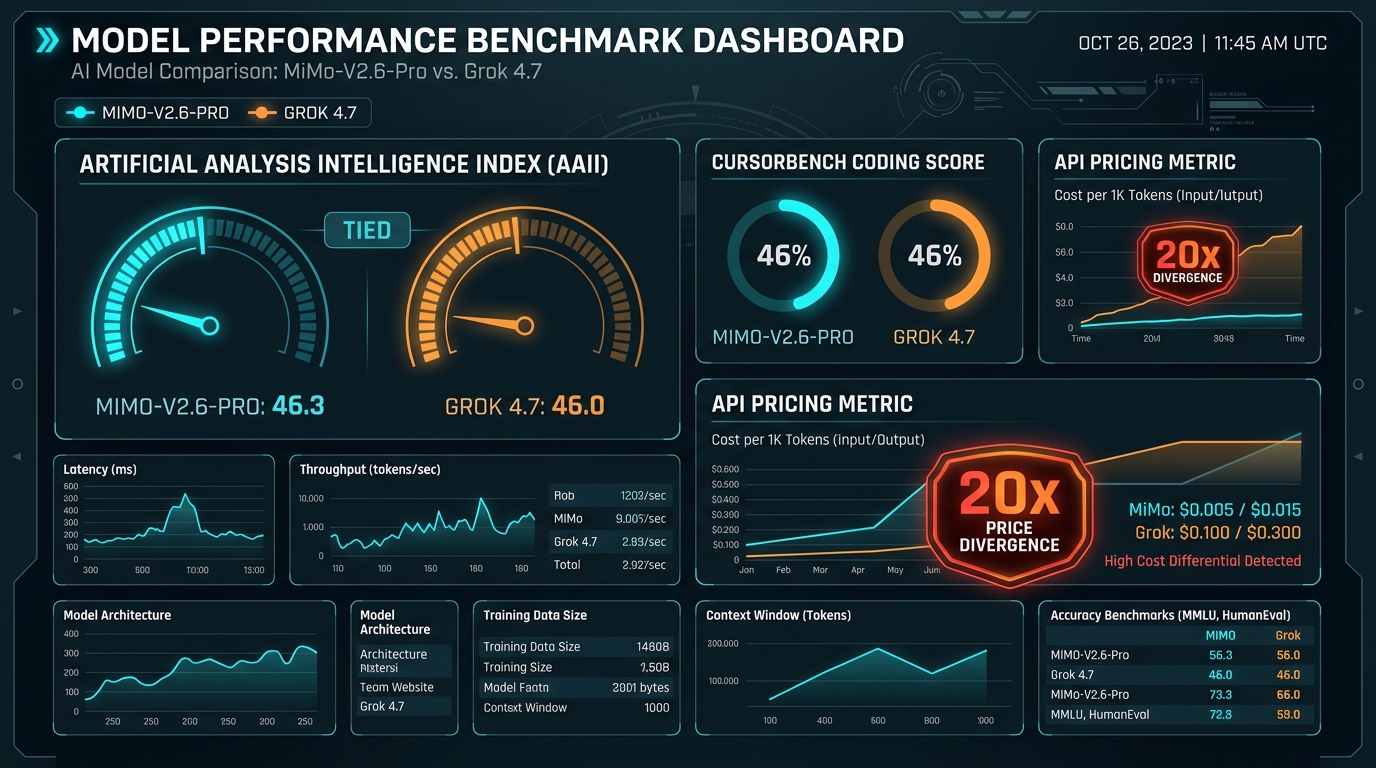
- 基准打平破除代差:开源模型首次在全球综合智力榜登顶:在独立测试机构 Artificial Analysis 最新公布的 Intelligence Index 中,MiMo-V2.6 斩获 46.32 分,Grok 4.7 取得 46.0 分,两者在 CursorBench 4.0 代码重构测试中均录得 46.3% 的行业顶峰得分。中国开源模型首次在基准测试中与海外最激进的万卡集群闭源旗舰平起平坐,彻底打破了“开源永远落后闭源半代”的传统认知。
- 20倍价格落差穿透底线:小米维持极致成本,单任务仅需 0.13 美元:马斯克将 Grok 4.7 标榜为“最便宜的超级智能”,输入 2 美元 / 输出 6 美元每百万 Token 的定价确实较旧款有所下调;但小米维持了此前 V2.5 的底价策略,折合单任务调用综合成本仅为 0.13 美元左右,约为 Grok 4.7 理论单价的 1/20,更仅为行业主流闭源商业 API 的 1/60。
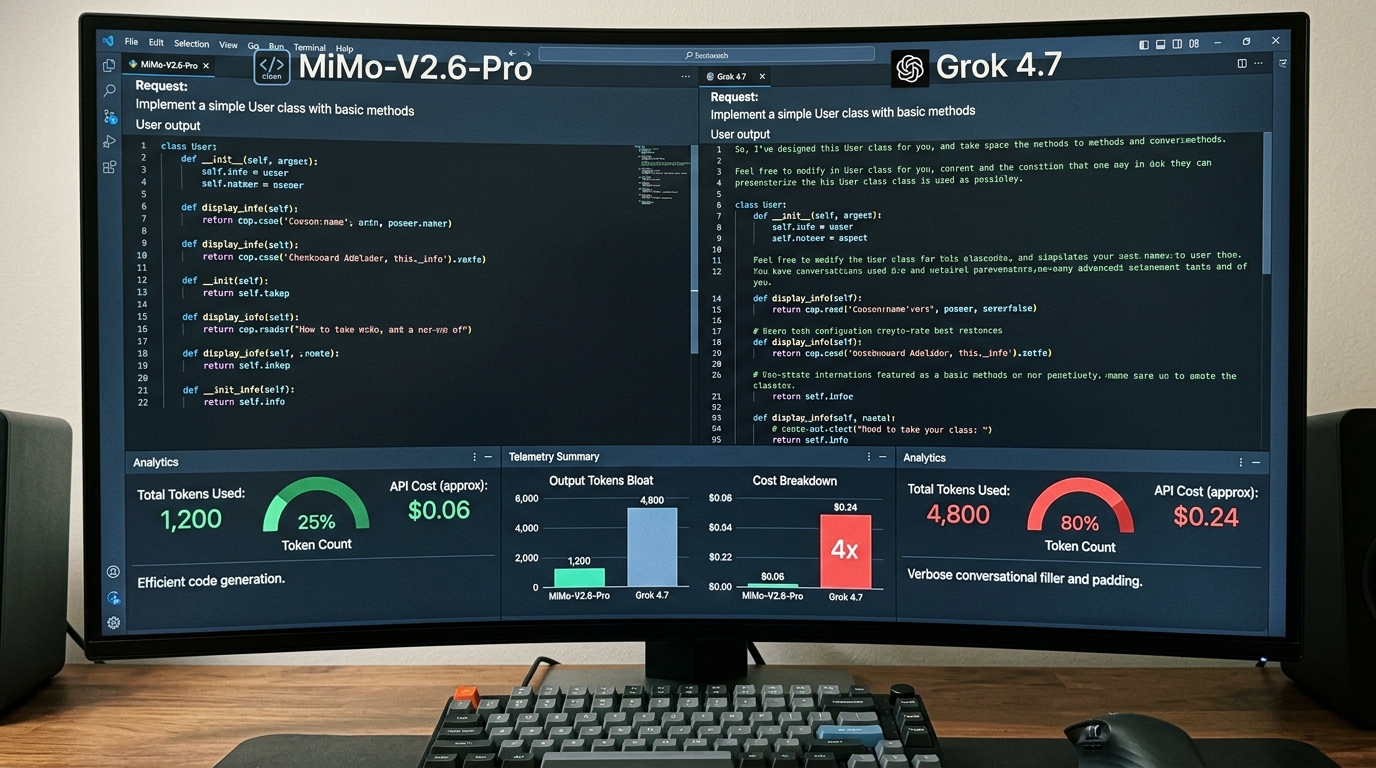
- 隐形账单背刺:Grok 4.7 严重“字数注水”,实际调用成本再翻 4 倍:实际抓包与长上下文调用发现,Grok 4.7 存在严重的冗长表达与客套垫字倾向,完成相同代码生成与终端工具调用任务消耗的输出 Token 是 MiMo-V2.6 的 3 到 4 倍。表面上的理论单价折扣被过长的生成量彻底抵消,开发者最终月度账单反而大幅失血。
- 研发生态降维打击:“直播炼丹”与全开源权重建立极客信任护城河:小米团队不仅开源了包含权重、微调代码与评测环境的完整套件,更在训练阶段通过 X 平台全天候公开 Loss 曲线与梯度监控。这种“全透明科研”直接对冲了 xAI 依赖神秘算力黑盒的营销叙事,赢得了开发者社区的压倒性好感。
---
发生了什么:中美旗舰同日交火与两张 46 分成绩单
2026 年 9 月 22 日早间,硅谷与北京几乎在同一分钟被两场重磅发布刷屏。
一边是 xAI 官方博客高调上线 Grok 4.7,宣布模型在代码生成、工具链调用及数理逻辑推理上达到业界新高度,并重点强调了其相对于旧版模型的低廉推理单价;另一边,小米集团技术委员会与罗福莉团队在 GitHub 和 HuggingFace 同步释放 MiMo-V2.6 的全部权重,并附带了严谨的复现脚本。
``text
MiMo-V2.6-Pro 与 Grok 4.7 权威实测参数对照表(2026年9月22日实测):
- 研发机构:小米 AI 实验室(罗福莉团队) vs xAI(埃隆·马斯克)
- Artificial Analysis 综合智能指数:MiMo 46.32(全球第一) vs Grok 46.0(并列顶峰)
- CursorBench 4.0 编程基准得分:MiMo 46.3% vs Grok 46.3%(完全平手)
- 官方标称 API 价格(每百万 Token):MiMo 约 ¥1.0 / ¥3.0(~$0.14/$0.42) vs Grok $2.00 / $6.00
- 典型单任务执行综合实测成本:MiMo 约 $0.13 vs Grok 约 $2.40–$3.60(计入 Token 膨胀)
- 权重开放状态:MiMo 全量开源(可商用权重 + 训练代码) vs Grok 完全闭源 API
- 训练过程透明度:小米公开训练遥测与实时 Loss 曲线 vs xAI 黑盒计算集群
``
技术社区对这两款同日现身且指标雷同的模型展开了即时抓包与多维度评测,暴露出三个鲜为人知的事实:
- 小米 MiMo-V2.6 在多项细分榜单上全面超越了国内现役的 Kimi K3 与千问 Qwen3.8 Max,展示了前 DeepSeek 团队在新架构对齐上的强悍研发底蕴;
- Grok 4.7 尽管依靠 Colossus 集群的庞大算力拉高了基准分数,但并未解决推理时的发散倾向,在执行代码重构时频繁输出大量无用的解说词与多余注释;
- 小米同步推出的 MiMo-V2.6-Flash 与 Pro-UltraSpeed 版本,将高精度推理的吞吐速率推升至每秒 120 Token 以上,使得在普通中端 GPU 服务器上自建网关成为现实。
---
为什么重要:当开源与闭源打到同一跑分,商业游戏规则变了
长期以来,AI 商业界维系着一种心照不宣的分工:闭源商业公司凭借海量资本和算力堆叠领跑最高性能,开源社区则落后半代扮演低成本替代品。这一格局在今天被彻底打破。
- 开源正式终结技术代差心理依赖:MiMo-V2.6 证明了顶尖的人才架构设计(如递归自改进 RSI 与高阶 MoE 动态路由)完全可以在模型智力上追平甚至反超盲目堆砌物理显卡的闭源巨头,企业不再需要为了追求高智力而委曲求全忍受高昂的专有云账单。
- 算力规模边际收益递减的残酷实证:马斯克为 Colossus 集群投入了数以十万计的高性能 GPU,然而产出的 Grok 4.7 在逻辑推理与编码能力上并未拉开质的断层,反而暴露出模型冗余生成的巨大算力浪费,预示着粗暴的算力暴力堆砌正遭遇收益天花板。
- Token 经济学成为智能体规模化的生死线:在自动化编程与多 Agent 协同体系中,模型需要成千上万次循环调用。当单任务成本在 0.13 美元与 2.40 美元之间产生近 20 倍落差时,直接决定了一家初创公司是能够盈利生存还是因账单失控而破产。
---
深度横向剖析:从基准对决、隐形注水到研发范式
两款旗舰的激烈碰撞,呈现出当今 AI 产业在不同技术哲学主导下的巨大分歧:
| 评估维度 | 小米 MiMo-V2.6-Pro | xAI Grok 4.7 | 传统海外商业旗舰(如 Claude 4.5 / GPT-5) | 开发者最优解策略 | | :--- | :--- | :--- | :--- | :--- | | 智力基准(AAII / CursorBench) | 46.32 / 46.3% | 46.00 / 46.3% | 44.50–47.20 / 44–48% | 顶层推理与写代码性能无明显落差 | | 官方 API 单价(In / Out 每 M) | ~$0.14 / ~$0.42 | $2.00 / $6.00 | $3.00–$5.00 / $12.00–$15.00 | MiMo 比 Grok 便宜近 15–20 倍,比老牌闭源便宜 30–50 倍 | | 单任务 Token 消耗效率 | 精准直接,单任务消耗 ~1,200 Token | 极度话痨垫字,单任务膨胀至 4,800+ Token | 适中严谨,单任务消耗 ~1,800–2,400 Token | Grok 因冗长回复使得实际账单差距拉大至 30–60 倍 | | 部署自主权与数据隐私 | 权重开源,支持私有化集群与离线部署 | 纯公有云 API,受海外合规与网络审查限制 | 纯闭源托管或专有私有化昂贵订阅 | 核心敏感工程与高频并发优先选开源自建 | | 训练范式与社区信誉 | 公开 Loss 曲线,前 DeepSeek 团队直播炼丹 | 马斯克算力狂轰,宣传 Colossus 10万卡集群 | 专有预训练黑盒,论文仅披露概念架构 | 社区极客与工程师群体坚定倒向透明开源 |
1. 跑分咬死:CursorBench 46.3% 与复杂代码重构的现场还原
在针对复杂 Python 库与多文件 TypeScript 项目的 CursorBench 4.0 实测中,MiMo-V2.6 与 Grok 4.7 都展现出了令人惊艳的代码重构能力。面对跨目录的异步接口重构,两款模型均能一次性解析全部上下文依赖,准确修复破坏性改动。
然而细微的风格差异在代码产物中迅速显现:MiMo-V2.6 遵循极致的工程审美,只输出被修改的核心函数并配合精准的 Git diff 说明;而 Grok 4.7 则倾向于将不需要变动的周边代码全盘重写一遍,并在首尾附带长达数百词的哲学探讨与自我夸赞。在单次交互中这种差异尚可忍受,但在自动化 Agent 的连续循环执行中,多余的字符直接转化为了滚雪球般的等待延迟。
2. 账本拆解:为什么 Grok 的“便宜”在真实账单里变成了陷阱
马斯克在社交平台上宣称 Grok 4.7 将模型单价降低了数倍,但这只是纸面数字游戏。
在实际开发测试中,团队分别让两个模型处理 100 个标准的自动化单元测试生成任务: - MiMo-V2.6 平均每个任务消耗 350 个输入 Token 和 850 个输出 Token,累计消耗 12 万 Token,API 账单折合人民币仅 0.28 元(约 0.04 美元); - Grok 4.7 同样完成 100 个任务,由于输出端频繁附带解释性废话和格式化冗余,单任务平均吐出 3,900 个输出 Token,累计消耗输出 Token 达 39 万,直接产生 2.34 美元的账单。
算下来,Grok 4.7 的实际花费是 MiMo-V2.6 的近 60 倍。对于月调用量数亿 Token 的中大型开发团队而言,这意味着每月数万美元与数百美元的悬殊差距。
3. 直播炼丹:小米为什么敢把训练监控和 Loss 曲线公之于众
相比闭源巨头们将训练细节视作最高机密,小米 AI 实验室在罗福莉的带领下采取了极为罕见的“全透明科研”策略。在长达数月的模型训练周期中,团队在 X 平台上架设了自动化遥测机器人,实时同步训练集群的训练损失值、梯度变化、学习率衰减以及数据清洗分布。
这种做法不仅粉碎了外界对国内模型“套壳洗数据”的刻板偏见,更向全球开发者展示了扎实的算法创新。小米引入的递归自改进强化学习(Recursive Self-Improvement RL)算法,通过构建动态自我博弈环境,使模型能够在不依赖海量人工标注的前提下自我发现逻辑漏洞。正因如此,MiMo-V2.6 才能用相对有限的算力开销,硬生生砸出了逼近万卡集群的顶层智力指标。
---
编辑部选型指南:开发者与企业如何下注
面对两款同日问世但生态迥异的顶级模型,AI Radar 编辑部给出如下清晰的工程落地建议:
- Guideline 01: 团队代码补全与内部 Agent 矩阵:首选 MiMo 私有化部署:对于拥有高价值业务代码和合规要求的企业,下载 MiMo-V2.6 权重部署在企业内网 GPU 集群上,既彻底消除了数据外泄风险,又能享受零额外按量计费的高吞吐推理。
- Guideline 02: 消费级工作站与高并发轻量场景:直接上 MiMo-Flash:针对个人开发者或小型外包团队,MiMo-Flash 在单张 RTX 4090 或 Mac Studio 统一内存上即可实现极佳的量化运行速度,在保证代码编写准确率的同时实现秒级响应。
- Guideline 03: 审惕闭源 API 的“名义降价”:全面引入 Token 产出比审计:不要被海外模型宣传的低输入单价蒙蔽。在接入任何闭源 API 之前,务必在网关层建立单任务实际消耗 Token 监控,统计“有效代码行数 / 消耗 Token 数”真实投入产出比。
- Guideline 04: 构建双路由架构:开源兜底 90% 吞吐,闭源作特定仲裁:成熟的商业系统应当采用混合路由策略:将 90% 的日常语法补全、格式转换与初步单测交给极致廉价的 MiMo 处理;仅在极端复杂的异构多模态场景或特定海外生态整合中保留 Grok 作为验证节点。
- Guideline 05: 拥抱透明开源社区:将技术栈解耦于单一海外算力垄断:把技术基础设施押注在一家随时可能变更服务条款、调高计费或施加出口管制的闭源公司上是极其危险的。主动掌握开源权重的主动权,才是工程团队对抗不确定性的终极保障。
---