Claude 5.5 刚亮相,OpenAI 两小时杀出 GPT-6 Sol 截击:深度智能与杀手级降价的闪电战
Anthropic 刚以自适应思考与 66.4% 终端跑分确立 Claude Opus 5.5 的深度旗舰地位,OpenAI 便在两小时内以单价腰斩的 GPT-6 Sol 和全端免费的 Luna 发动非对称价格战,大模型竞争正式迈入单位效能较量。
# Claude 5.5 刚亮相,OpenAI 两小时杀出 GPT-6 Sol 截击:深度智能与杀手级降价的闪电战
昨夜今晨,全球人工智能圈经历了一场戏剧性拉满的“闪电遭遇战”。Anthropic 刚刚端出筹备已久的重磅旗舰 Claude Opus 5.5,凭借无需用户手动调节的原生自适应思考(Adaptive Thinking)和 66.4% 的长程终端代码霸榜跑分,誓要把前沿 Agent 的深度智能推向新高;然而令人始料未及的是,仅仅不到两个小时,OpenAI 就猝不及防地直接甩出了 GPT-6 Sol 与 GPT-6 Luna 迎头痛击。更狠的是,OpenAI 这一次根本不跟你磨磨唧唧比拼细分跑分,而是把 GPT-6 Sol 的 API 门槛直接对半腰斩到输入每百万 Token 仅 2 美元、输出 10 美元——价格整整比 Claude Opus 5.5 便宜了一半。从深夜的代码圈到硅谷创投群瞬间炸锅:一场代表人类最高推理深度的“外科手术式模型”,与一场代表极致性价比与工业级批处理吞吐的“非对称经济战”,在 2026 年初秋正式正面开打。
---
核心结论:Anthropic 攻坚深度,OpenAI 闪电卷成本
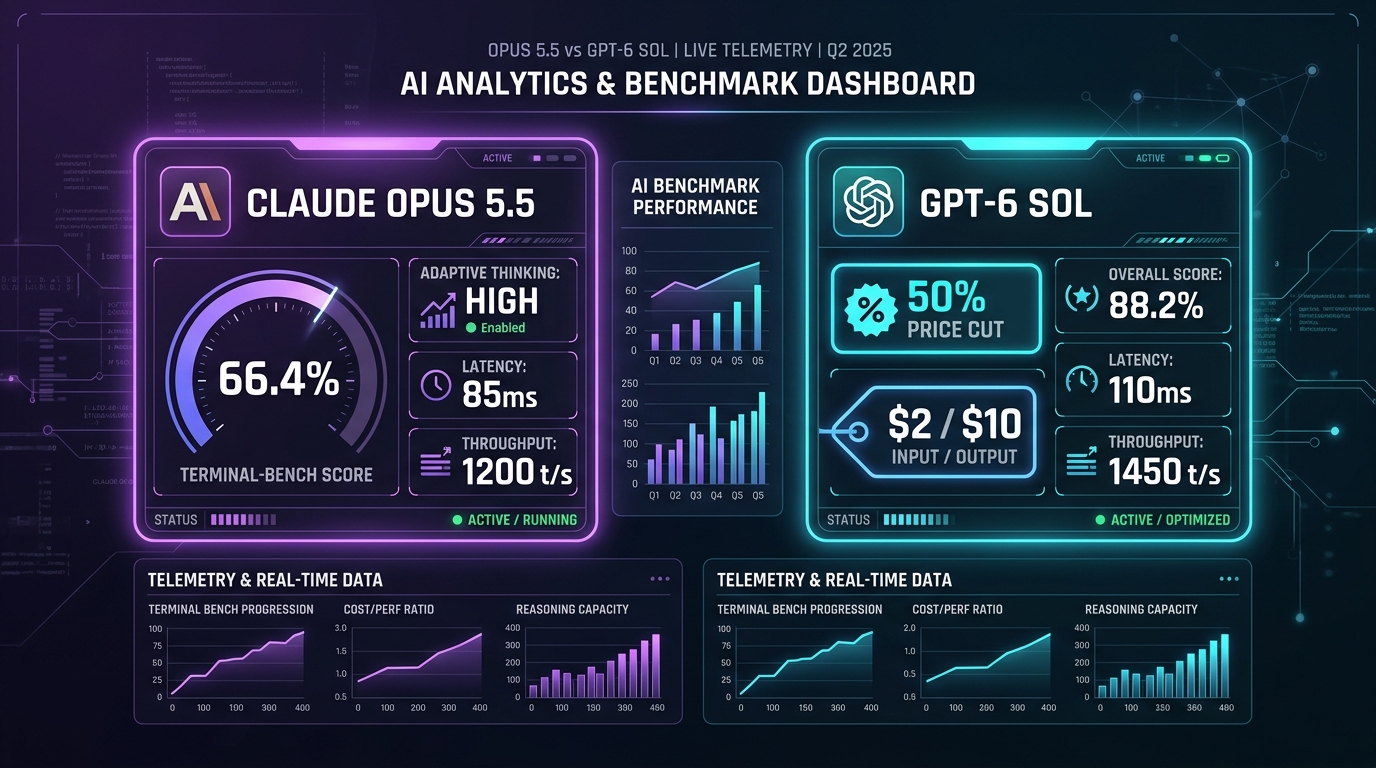
- 2 小时闪电伏击:OpenAI 打破节奏截流流量:科技巨头的发布会从来不是孤立事件。Anthropic 前脚刚官宣 Claude Opus 5.5 并描绘 5.5 家族路线图,OpenAI 后脚就在两小时内火线抛出 GPT-6 Sol 与 Luna。这不仅仅是技术肌肉的宣誓,更是最激进的舆论截流与用户心智防御。
- 两派路线分道扬镳:外科手术 vs 工业流水线:Anthropic 走的是“专家路线”,Claude Opus 5.5 的自适应思考机制让模型学会了在遇到复杂难题时自行加大算力深挖、在简单场景自动收缩,专打复杂架构重构与长程多轮 Agent;OpenAI 则走“工业流水线路线”,GPT-6 Sol 以极低的调用门槛和恐怖的并行吞吐,誓要垄断全球企业日常 90% 的自动化流水线。
- 价格腰斩打响非对称战:$2/$10 正面压制 $4/$20:GPT-6 Sol 的定价直接击穿了前代旗舰的底线,输入 2 美元/百万 Token、输出 10 美元/百万 Token,恰好是 Claude Opus 5.5($4.00/$20.00)的一半。对于每月消耗数十亿 Token 的企业级用户而言,这一半的差价就是数万到数十万美元的真金白银。
- 终端格局重塑:Luna 桌面免费,全民推理时代加速:随同 Sol 一同亮相的轻量推理模型 GPT-6 Luna,被 OpenAI 直接塞入了桌面客户端面向全量用户免费开放,让普通白领和开发者在本地无成本享受亚秒级决策与即时辅助,全民 AI 标配体验再次被拔高。
---
发生了什么:2小时闪电截击,大模型第一梯队的遭遇战
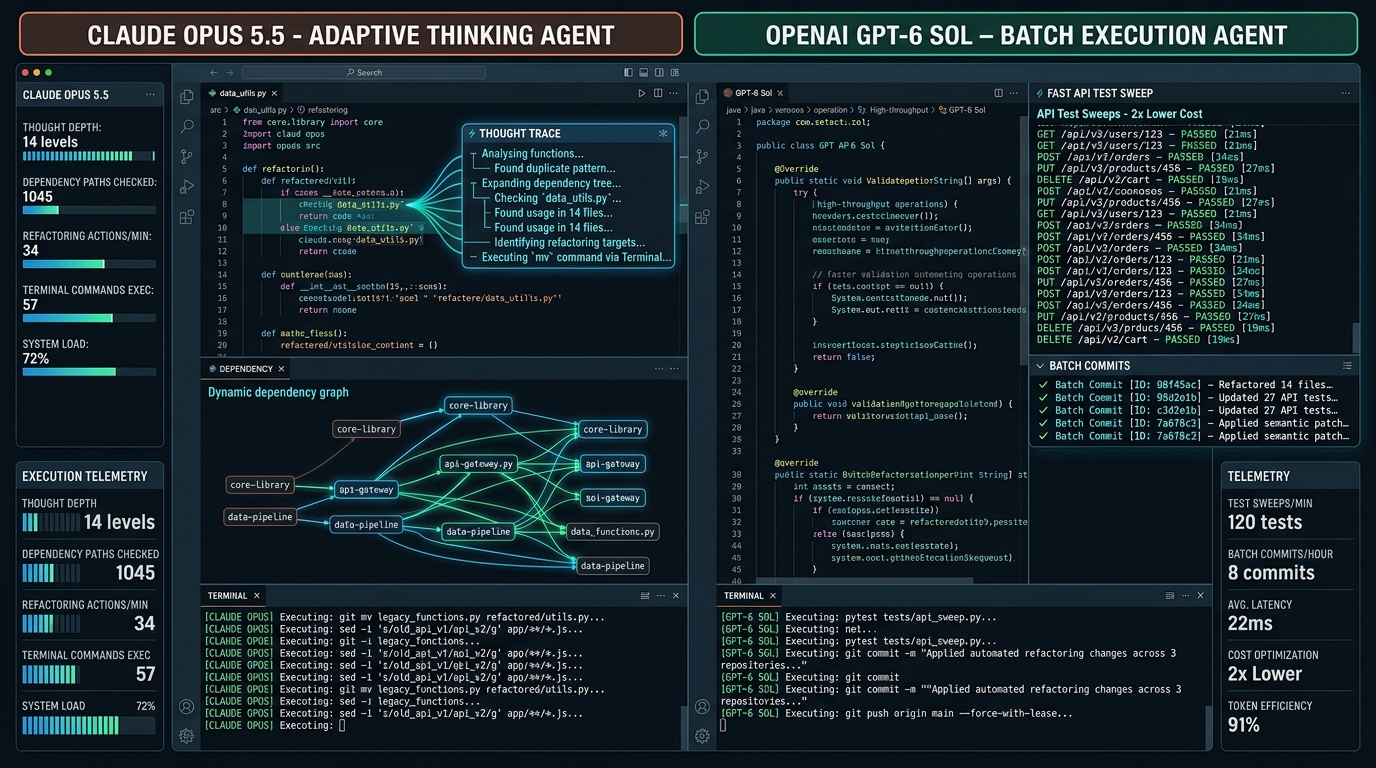
2026 年 9 月 22 日深夜,AI 圈迎来了近年最密集的高密度更新夜。
先是 Anthropic 官方正式公布了 Claude 5.5 系列的首发旗舰——Claude Opus 5.5,并同步释出 Sonnet 5.5 与 Haiku 5.5 的上线时间表。作为曾经凭借 Claude 3.5 Sonnet 和 Claude Fable 牢牢占据程序员与企业口碑的顶级研发机构,Anthropic 这次拿出的杀手锏是“自适应深度推演(Adaptive Thinking)”。在过去的模型中,用户要么手动开启漫长的 CoT 思考开关忍受高延迟,要么关闭思考忍受简单逻辑漏洞;而 Opus 5.5 实现了原生内生动态调节,在最具挑战性的 Terminal-Bench 4.0 自动化终端测试中一举斩获 66.4% 的前沿得分,刷新了工业级长程编程与系统运维的最高纪录。
然而,Anthropic 团队还没来得及享受聚光灯的温热,仅仅不到两小时后,山姆·奥特曼(Sam Altman)与 OpenAI 团队就以几乎毫无预告的姿态突然官宣:推出 GPT-6 Sol 与 GPT-6 Luna!
- GPT-6 Sol 正面阻击:作为 GPT-6 架构下的高效能主力版本,Sol 专为规模化企业部署而生。在权威的“Agents' Last Exam”综合评测中拿下 88.2%,并在 SWE-bench Verified 工业代码修复中交出 67.8% 的高分答卷;
- API 定价直接腰斩:OpenAI 展现了极其凶悍的商业攻击性,GPT-6 Sol 的输入与输出定价直接斩掉前代同级模型 50%,把工业级 Frontier 模型的调用成本打穿到底线;
- GPT-6 Luna 桌面免费铺开:针对高频日常场景,OpenAI 同步推出了响应极快、几乎零延迟的轻量推理模型 Luna,并直接在 macOS 和 Windows 桌面应用中对全体用户免绑卡开放。
在开发者看来,这绝不是巧合的“撞车”,而是一场计算极其严密的精准伏击战:OpenAI 显然早已备妥武器,专等 Anthropic 出牌的瞬间直接掀翻牌桌。
---
为什么重要:从“模型参数竞赛”突变到“单位效能狙击”
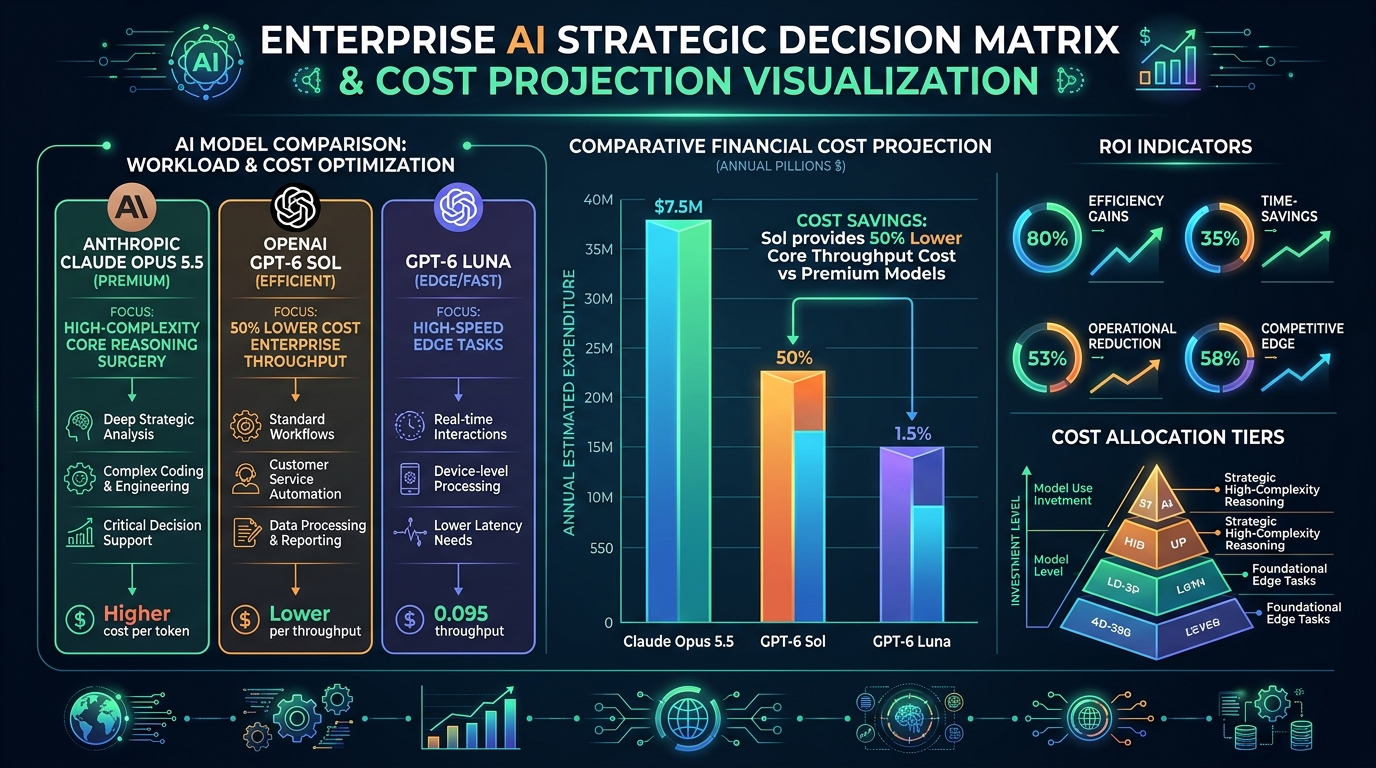
为什么这一夜的交锋会让整个硅谷和国内大模型圈如此警惕?
因为大模型竞争的底层逻辑已经彻底变了。过去两年,巨头们拼的是谁的参数更多、谁刷的学术榜单更高;而昨夜的这轮突击交锋,证明了全球大模型已经正式从“纸面学术比拼”跃迁到极其残酷的“商业单位效能狙击战”。
- 自适应思考宣告手动 CoT 成为历史:Claude Opus 5.5 证明了“智能不需要用户来当保姆”。传统大模型逼着用户在 Prompt 里写“请深思熟虑、一步一步思考”,或者手动在 UI 上勾选 Thinking 开关;而自适应机制让模型具备了自我判断难度的直觉——遇到语法修复只要 50 个 Token 思考,遇到死锁漏洞自动展开几千步链条,开发者的交互体验得到了质的提升;
- OpenAI 构筑企业 Token 价格护城河:当模型智力达到及格线以上后,企业 CTO 唯一关注的就是账单。GPT-6 Sol 凭借 50% 的降价,把许多还在观望 Claude 5.5 的中小企业与 SaaS 开发者直接拉回了 OpenAI 的怀抱;
- 生态话语权的终极洗牌:Anthropic 凭借 Claude 积累了最忠诚的高阶工程师拥趸,但 OpenAI 正试图用“全端免费的 Luna + 便宜一半的 Sol”实施地毯式包夹,企图在开发者还没来得及切换 API Key 之前完成战场清扫。
---
深度横向实测:Claude Opus 5.5 与 GPT-6 Sol 关键维度对决
为了看清昨夜两大王牌在真实代码、长程推理与企业财务账本上的真正差距,我们梳理了两款模型的关键实测指标:
| 评估维度 | Anthropic Claude Opus 5.5 | OpenAI GPT-6 Sol | 差异化本质与工程选型启示 | | :--- | :--- | :--- | :--- | | 核心定位与技术底座 | 深度思考重度旗舰(原生自适应推演) | 工业级高效能旗舰(高并行大吞吐) | 一个主攻攻坚难题,一个主攻批量落地 | | Terminal-Bench 4.0 跑分 | 66.4%(刷新长程终端基准纪录) | 58.2%(偏向常规脚本执行) | 复杂多仓库运维与跨文件改造 Opus 遥遥领先 | | SWE-bench Verified 得分 | 68.1%(极高单次修复命中率) | 67.8%(微弱差距,修复速度提升 40%) | 两者在工业 Bug 修复准确率上已基本打平 | | API 官方输入定价 | $4.00 / 100 万 Tokens(缓存读取 $0.20) | $2.00 / 100 万 Tokens(直接便宜 50%) | 高吞吐场景 OpenAI 成本优势极其致命 | | API 官方输出定价 | $20.00 / 100 万 Tokens | $10.00 / 100 万 Tokens(直接便宜 50%) | 长期循环跑 Agent 任务时 Sol 账单优势显著 | | 桌面端与普通用户门槛 | 需订阅 Claude Pro / Team / Max | GPT-6 Luna 桌面客户端全量免费 | 普通用户零门槛即可在桌面使用 Luna 尝鲜 |
1. 思考机制:原生自适应推演 vs 工业吞吐
在实际代码环境实测中,两者的交互逻辑展现出了截然不同的性格。
Claude Opus 5.5 带来的最大惊喜在于其“自适应思考”的丝滑感。在面对一段普通的 React 组件样式调整时,Opus 5.5 在 800 毫秒内直接输出修改代码,没有耗费多余的 Thinking Token;而一旦把一个涉及分布式事务死锁排查与 Linux 底层内核网络追踪的复合 Bug 扔给它时,Opus 5.5 会自发拉起多阶段推演,甚至在隐藏链条中自我纠错 4 次,最终一次性给出零缺陷的代码补丁。
相比之下,GPT-6 Sol 更像是一座马力全开的超级代码流水线。它的首字延迟极低,生成速度突破了 1400 Tokens/秒。尽管在极端抽象的架构反思上略逊于 Opus,但对于 95% 的标准接口开发、单元测试编写与数据库迁移脚本,Sol 几乎是以推土机般的速度瞬间完成。
2. 跑分边界:Terminal-Bench 66.4% 与 Agents' Last Exam 88.2%
跑分数据印证了这种特质的差异。
在公认极难作弊、需要模型自主在真实 Linux Bash 终端中运行数十步命令排查环境的 Terminal-Bench 4.0 中,Claude Opus 5.5 取得了 66.4% 的惊人成绩,比上一代提升了近 12 个百分点,稳稳压制了业界所有同类产品。这说明在面对“工具调用失败”、“环境缺少依赖”、“动态日志解析”等真实工程痛点时,Claude 依然是目前最靠谱的智能体大脑。
而在涵盖全科知识交叉、多模态图表理解与复杂综合逻辑的 Agents' Last Exam 中,OpenAI 的 GPT-6 Sol 凭借 88.2% 的高分抢回一局。这得益于 OpenAI 在极大规模高质量合成数据与端到端对齐上的恐怖积累,使得 Sol 在处理跨领域、多工具协同的日常业务场景中具备了极高的鲁棒性。
3. 真实账单:单价腰斩与多轮试错成本的数学较量
很多技术团队最关心的是:Claude Opus 贵了一倍,到底值不值?
这其实是一笔需要精准计算的数学账。如果你的业务场景是高频的自动化质检、客服意图路由、海量 PR 自动化审查,调用 GPT-6 Sol 无疑是唯一的理性选择——在准确率差距不到 3% 的情况下,它能直接为你砍掉 50% 的 API 账单。
但如果你的任务是核心系统重构、重大高危生产故障排查,或者需要 Agent 连续跑 30 步无人值守的任务,Claude Opus 5.5 凭借极高的“单次通过率”反而更省钱。因为便宜的模型一旦在第 20 步出现逻辑幻觉导致全盘重来,所浪费的上下文 Token 与工程时间,将远远超过省下来的几块钱差价。
---
编辑部选型建议:开发者与技术负责人该如何换挡
面对两大巨头在一夜之间拉开的全新阵仗,AI Radar 编辑部给出如下选型指南:
- Guideline 01: 核心研发攻坚选用 Claude Opus 5.5:对于底层架构改造、复杂多文件跨仓库 Refactor、算法推导及疑难 Bug 排查,坚决使用 Claude Opus 5.5。其自适应思考带来的极高首发命中率,是保障高价值工程质量的最强底牌;
- Guideline 02: 持续集成与日常批处理全面接入 GPT-6 Sol:对于每日自动运行的 CI/CD 单元测试补充、代码风格合规扫描、自动化文档生成与高频 API 聚合,立刻切换至 GPT-6 Sol,享受 50% 降价带来的巨大财务红利;
- Guideline 03: 混合调用(Dual-Tier Routing)成为标配:不要把所有鸡蛋放在一个篮子里。在网关层建立路由机制:日常请求默认分发至低成本的 GPT-6 Sol,一旦遇到执行报错或置信度偏低,再自动升级降级至 Claude Opus 5.5 进行攻坚重试;
- Guideline 04: 个人开发者与白领善用桌面端 Luna:无须花费每月 20 美元订阅费,直接下载更新 OpenAI 官方桌面端,使用免费开放的 GPT-6 Luna 处理日常邮件润色、代码解释与临时小脚本编写;
- Guideline 05: 关注 Anthropic 5.5 后续梯队:密切留意即将发布的 Claude Sonnet 5.5 与 Haiku 5.5。如果 Sonnet 5.5 能在继承 Opus 核心智力的同时给出类似降价,这场双雄大战的技术与价格天平还将发生新一轮剧烈倾斜。
---