Gemini 4 突袭上线:吹得挺神,实测额度光速见底!
谷歌低调突袭上线的 Gemini 4(Argon)再次上演了“公关文案跑在体验前面”的戏码——虽然百万 Token 吞吐和深度推理纸面数据亮眼,但在真实的 Antigravity 编程实测中,原本能用 5 小时的配额十几分钟即被烧光,复杂业务逻辑依然落后于 Claude Opus 5.5;高昂的使用成本配合随时熔断的吝啬配额,暴露出谷歌在端侧体验与算力调度上的深层矛盾,没有给开发者带来真正的颠覆性惊艳。
# Gemini 4 突袭上线:吹得挺神,实测额度光速见底!
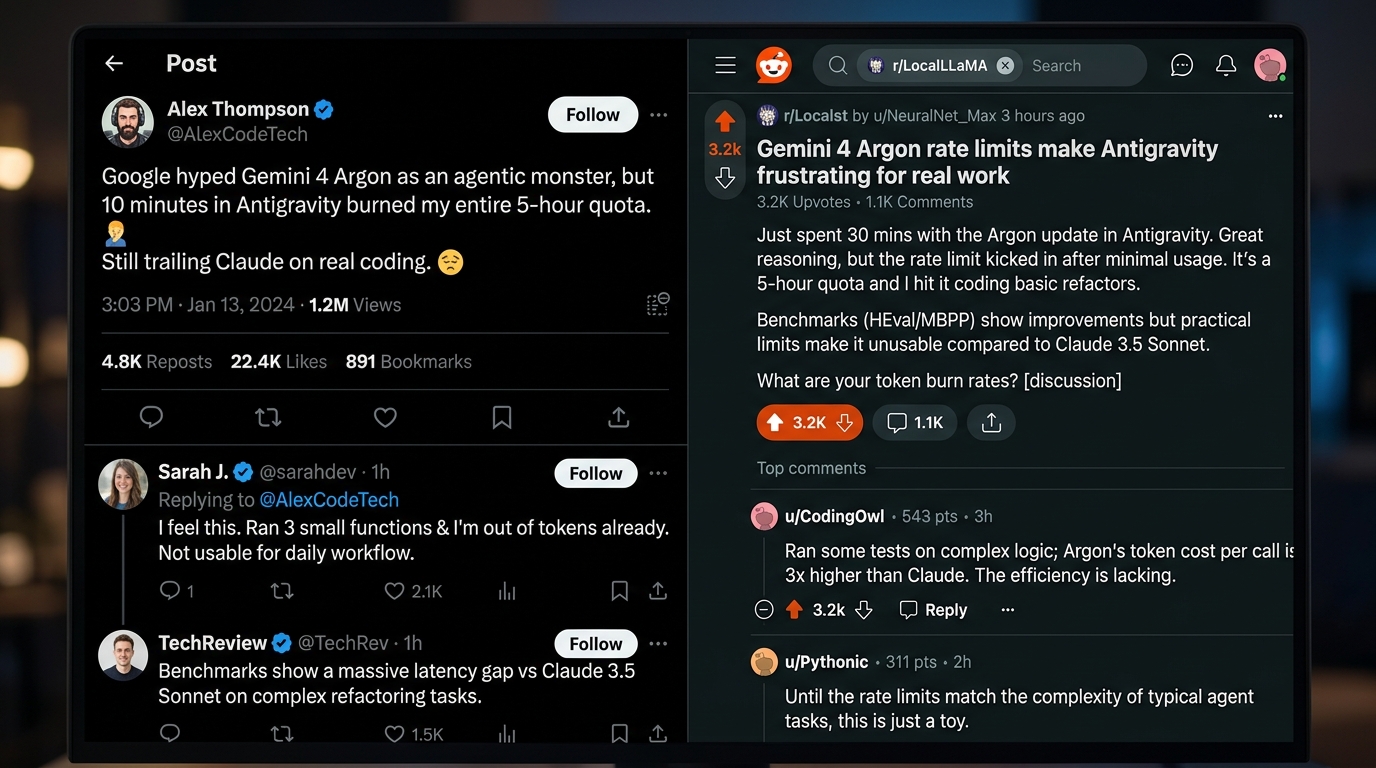
2026 年 10 月 13 日,谷歌毫无预告地全面上线了新一代旗舰模型 Gemini 4(内部代号 Argon)。官方博客写得天花乱坠:百万 Token 连续输出、长链路深度推理、专为 Antigravity 自动化代码架构打造,仿佛一出手就要终结大模型战局。然而各大技术社区和第一批付费开发者的实测反馈却泼来一盆冷水——跑分榜单看着很凶,一上手还是打不过第一梯队;更恶心的是,Antigravity 里刚跑了十几分钟复杂重构,原本能用 5 小时的额度就光速告罄。
结论
谷歌每次发新模型,公关文案永远比真实产品先到一步。Gemini 4 Argon 确实能打,但根本没有带来质变的惊艳感。它离 Claude Opus 5.5 和 GPT-6 这类真正能啃硬骨头的顶级选手依然差着半个身位,却早早学会了顶奢模型的定价和极度抠搜的限流策略。对普通开发者来说,现在的 Gemini 4 更像一台昂贵的“算力焚化炉”——你还没看清它到底行不行,配额就已经被它烧得干干净净了。
发生了什么
10 月 13 日,谷歌向 Google AI Pro、Ultra 订阅用户以及 Vertex AI 企业通道全面开放了 Gemini 4 Argon。根据皮查伊团队的宣发口径,新模型彻底解决了前代“复读机”、“客套废话多”的毛病,主打在 Antigravity 深度编程环境里的跨文件协同与自主调试。
然而尝鲜用户刚把模型接入日常工作流,吐槽声就瞬间淹没了 Reddit 和 X 平台:
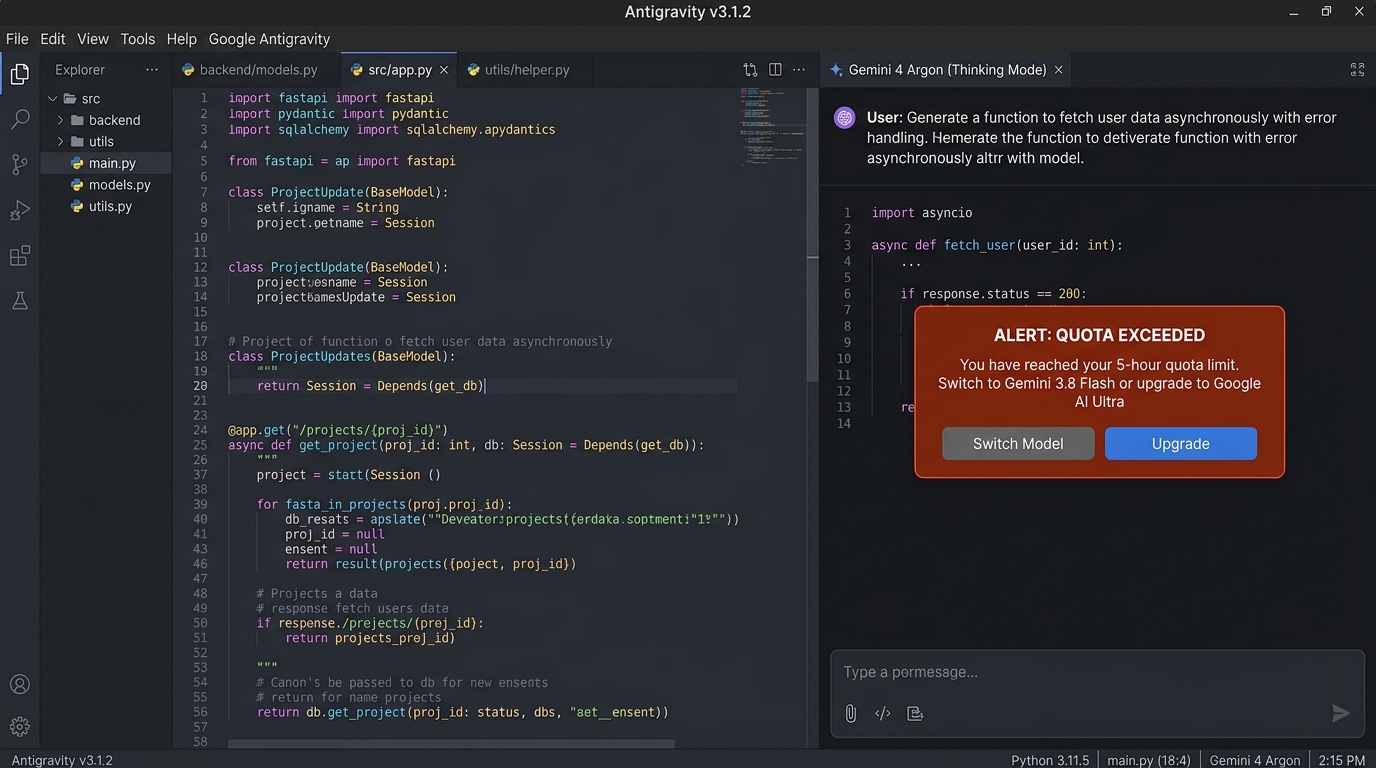
首先是让人窒息的配额崩塌。在 Google Antigravity 里,Pro 用户原本拥有一个 5 小时滚动的配额池。但在 Gemini 4 身上,随便扔两份包含图表和长上下文的代码库,或者让它执行一次三步以上的工具链调用,配额指示条就会以 15% 到 25% 的速度断崖式下跌。不少人反馈,仅仅正常联调了 10 到 15 分钟,界面就直接弹出一道冰冷的红框:“您的 5 小时配额已耗尽,请降级回 Flash 或升级至 Ultra”。
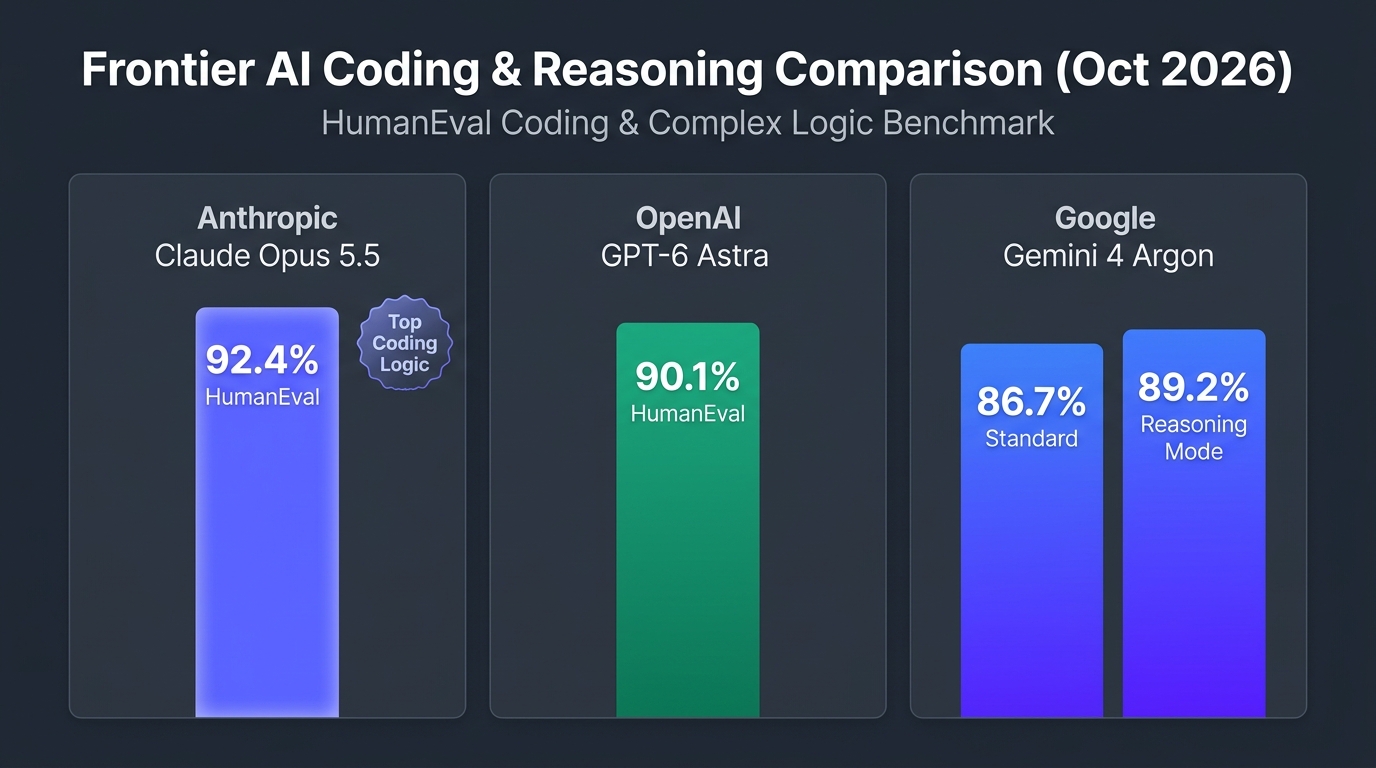
其次是真实智力的微妙差距。在官方基准上,Gemini 4 刷出了极高分数;但在没有开启最高推理档位时,它在解决复杂并发死锁、冷门框架魔改代码时依然频频翻车。开发者发现,必须把思考深度拉到最高档(Extra High),它才能交出接近竞品水准的答案——而这种模式消耗的算力,普通人的订阅套餐根本撑不过三轮对话。
为什么重要
这次用户的集体落差,再次把谷歌大模型的老毛病推到了聚光灯下。
跑分没赢过,烧额度没输过:5小时配额几分钟蒸发
大模型竞争到了 2026 年,单纯拼上下文长度早就糊弄不了人了。谷歌引以为傲的所谓百万 Token 吞吐,在实际工程里直接变成了吞噬额度的黑洞。
很多开发者原本指望 Antigravity 能像老练的工程师一样替自己把关多文件重构,结果 Gemini 4 边写边烧算力,任务刚执行到一半就因额度熔断而卡死在半空中。这种“上一秒还在干活,下一秒就强行断电”的体验,不仅没有提升效率,反而给日常开发制造了巨大的焦虑。
离第一梯队差半档:复杂任务必须“硬开深度思考”
客观来说,Gemini 4 绝不是劣质模型,它的语言精简度和中文理解比旧版有明显进步。但问题在于,大家对它的期待是“掀翻 Claude 和 OpenAI 的灭霸”,而实际拿出来的只是一个“补课优等生”。
在面对涉及复杂业务逻辑的真实工程问题时,Claude Opus 5.5 往往能一次性切中要害,给出结构严谨的解法;而 Gemini 4 在标准模式下依然容易漏掉关键边界条件,非要逼你打开最消耗额度的高强度推理模式才能补齐短板。这种“不充重金就不灵”的表现,让不少抱着换门心态来的用户倍感失望。
逼氪套路与高昂账单:谷歌的旗舰焦虑症
除了体验拉胯,谷歌的商业化吃相也引发了不小反弹。
20 美元一个月的 Pro 会员根本经不起消耗,页面上到处明晃晃地提示你升级到每月 100 甚至 200 美元的 Ultra 尊享版;而在 API 侧,百万输出 Token 收费 10 美元,早鸟优惠期一过还要翻倍。高昂的使用门槛加上随时暴毙的配额,让很多中小型团队在算了一笔账后,果断退回了性价比更高的第三方聚合通道。
我们的判断
在 AI Radar 看来,Gemini 4 的这次登场暴露出谷歌在算力分配和产品定义上的深层矛盾:
- 基础设施储备与用户体验严重脱节:谷歌坐拥全球最豪华的 TPU 算力集群,但在面对终端用户的配额分配上却表现得比创业公司还要吝啬;算力不敢给足、模型全靠强行限流维系,直接断送了 Antigravity 本该拥有的丝滑感。
- 缺乏真正一锤定音的技术惊艳:从 Gemini 1.0 到如今的 Gemini 4,谷歌始终处于“追赶者”的防御态势;每一代都在死磕别人几个月前设立的基准,却始终拿不出像初代 Transformer 或 ChatGPT 那样颠覆认知的新范式。
- 务实性价比才是普通人唯一的选型标准:对干活的工程师来说,没有好用的额度,再宏大的大模型也是空中楼阁;当头部梯队已经把高智商模型打成白菜价时,谷歌如果继续玩高价限流的逼氪套路,只会进一步推开核心开发者。
仍然要观察
- 面对全网对配额熔断的抱怨,谷歌是否会在接下来的小版本更新中放宽 5 小时滚动窗口的 Token 消耗乘数。
- 随着各路独立评测机构展开无提示词代码盲测,Gemini 4 与 Claude Opus 5.5 的真实胜率是否会进一步拉开。
- Google AI Studio 上的开发版 API 在 11 月底结束早鸟折扣后,高昂的定价是否会导致企业级用户的大规模流失。