RLHF 鼻祖背叛生成式 AI?OpenAI 核心出走两年掏出 Jev:一个不吐字、成本狂降400倍的“超级 if”

前 OpenAI 核心算法元老、RLHF 与 InstructGPT 共同发明人 Diogo Almeida 携 TypeSafe AI 上线首个非生成式系统 1 模型 Jev。它砍掉自回归文本生成,专注高频强类型决策,跑出 193 倍速度跃迁与 444 倍成本暴跌,输出 Token 永久免费。配合 RLCD 概率校准算法,Jev 成为专为代码与 Agent 设计的原生基础设施。随着语义理解决策成本逼近为零,智能将遵循杰文斯悖论全面接管软件世界的每一个 if 语句。
# RLHF 鼻祖背叛生成式 AI?OpenAI 核心出走两年掏出 Jev:一个不吐字、成本狂降400倍的“超级 if”
2026 年 9 月 15 日,隐身创业两年的前 OpenAI 核心算法元老、RLHF(人类反馈强化学习)与 InstructGPT 共同发明人 Diogo Almeida 携新公司 TypeSafe AI 正式亮相,宣布完成 4000 万美元融资,并上线了被业界誉为“两年来最怪异也最性感”的新模型——Jev。与全网死磕长文本、卷长篇推理与文采飞扬的传统大模型截然相反,Jev 是一个彻头彻尾的“非生成式”系统 1(快思考)模型:它不聊天、不写文章、不吐代码,甚至连一个标点符号都无法生成。它只做一件事——高频决策判断。砍掉自回归吐字后,Jev 的响应提速至 70–500 毫秒(提速最高 193 倍),调用成本骤降 444 倍(每百万 Token 仅 0.042 美元,输出 Token 永久免费),并依靠首创的 RLCD 强化学习算法实现严谨的概率校准。这位一手让 GPT 学会说人话的鼻祖,为何会亲手把“生成文字”送上断头台?当一次高阶语义决策便宜到接近不要钱,软件世界的每个 if 语句又将迎来怎样的重构?
---
核心结论:AI 为何一定要生成内容?当决策便宜到不要钱
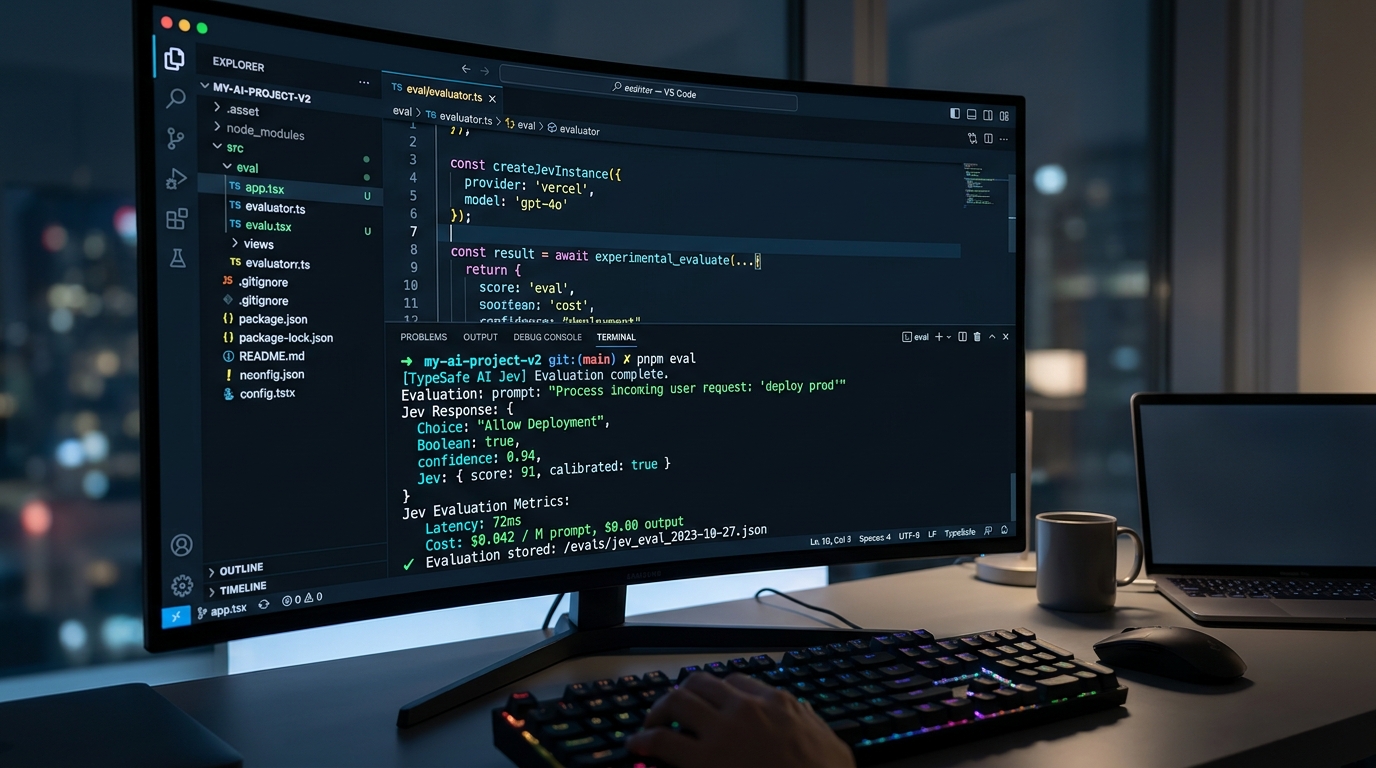
- 颠覆自回归盲从:砍掉文字生成,直奔机器原生的确定性结果:过去三年,大模型行业被 ChatGPT 的巨大成功带入了一种思维定势,认为智能必须体现为“生成一段通顺的文字”。但当智能的最终接收端不是人类双眼、而是一段软件代码或自动化 Agent 时,长篇大论的客套与解释全是浪费。Jev 彻底剥离了自回归文本生成,直接输出强类型数据(Choice 单选枚举、Score 连续评分、Boolean 布尔判定)。这从物理底层彻底绝缘了解析报错与格式幻觉,成为真正为机器与程序打造的原生模型。
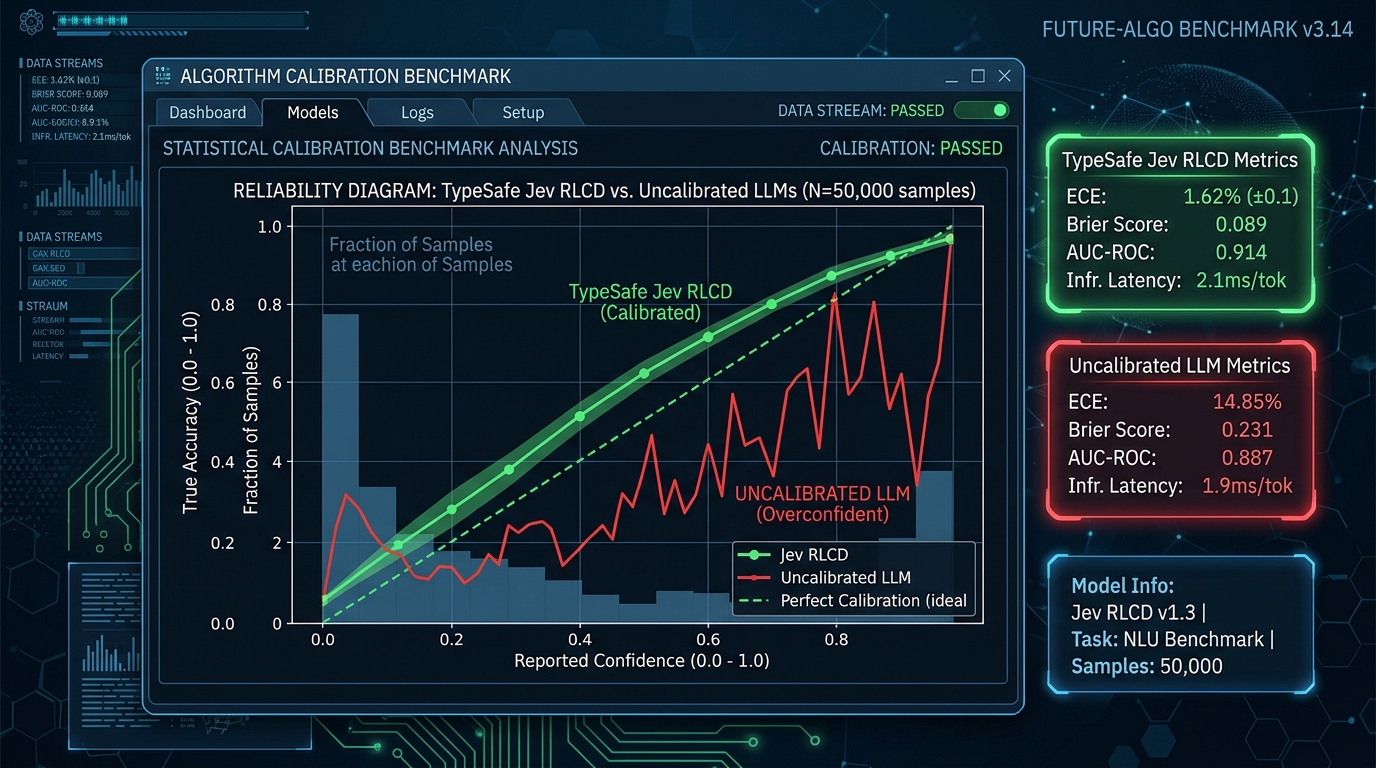
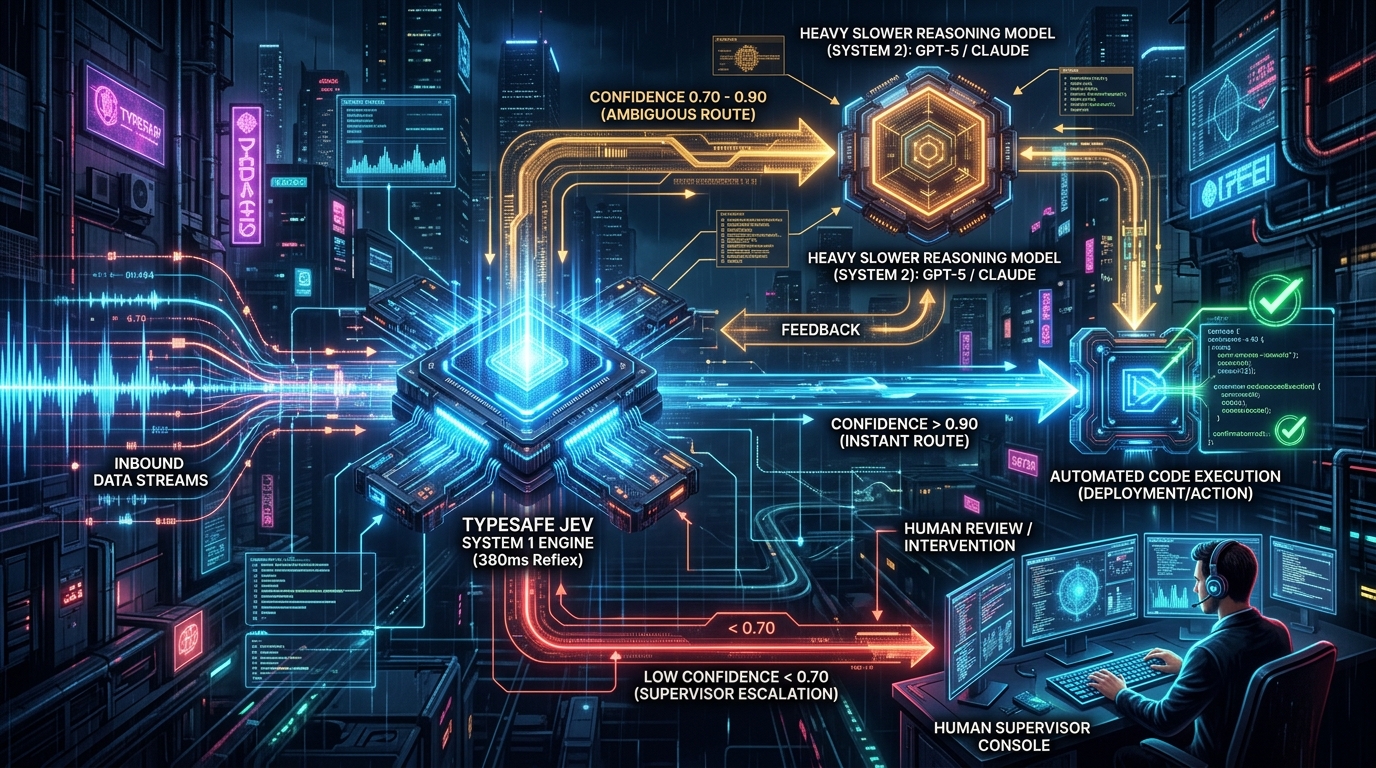
- 首创 RLCD 校准强化学习:打破盲目自信,让概率拥有严谨数理意义:RLHF 优化的是人类的主观审美(怎么回答更讨喜),RLVR 优化的是数学与单测的可验证解,而 TypeSafe 自研的 RLCD(面向校准决策的强化学习)优化的则是“决策准确率与概率校准(Calibration)”。当 Jev 给出“90% 置信度”时,其真实测试准确率在统计学上严格收敛于 90%。这让自动化流水线拥有了可靠的分级依据:高置信直接静默执行,中置信上浮至昂贵重模型,低置信熔断给人工,告别了大模型常见的“一本正经胡说八道”。
- 性能与成本的降维打击:380ms 极速响应与永久免费的输出 Token:在 Vercel AI SDK 的工作流评测中,Jev 相比传统前沿大模型跑出了最高 193.6 倍的速度跃迁与 444.6 倍的成本暴降。其平均端到端响应仅需 380 毫秒,输入每百万 Token 仅收 0.042 美元,而输出 Token 直接标价 0.00 美元(免费)。因为只返回类型化决策而非成千上万个字符,计算开销极其微小,平台直接免收输出费用。
- 商业与架构启示:智能的“杰文斯悖论”正在现实中发生:模型取名 Jev,致敬的是 19 世纪英国经济学家提出的“杰文斯悖论”——蒸汽机效率越高、耗煤越省,反而导致社会总耗煤量暴涨。TypeSafe 赌的是:当一次具备世界知识的语义判断便宜到可以忽略不计、快到媲美本地函数时,人类不仅不会少用智能,反而会把智能注入到每一个软件 if 语句、浏览器过滤钩子、游戏循环和网络数据包中。
---
发生了什么:隐身两年的 OpenAI 功勋,造了一个“哑巴”模型
在人工智能发展史上,Diogo Almeida 是一个绕不开的关键人物。在 OpenAI 任职期间,他作为核心研究员参与开创了 RLHF 与 InstructGPT。正是这套让模型理解人类意图、学会礼貌对齐并准确听从指令的方法论,最终直接催生了轰动全球的 ChatGPT 与 GPT-4。
然而,就在大语言模型如日中天的 2024 年初,Diogo Almeida 却悄然选择了离开 OpenAI,拉上联合创始人 Erik Gafni 与 Sasha Sheng 创立了 TypeSafe AI。在长达两年的深潜隐身之后,他们终于在 2026 年 9 月 15 日揭开面纱,同时宣布完成 4000 万美元巨额融资,并上线了他们的首个模型——Jev。
``text
TypeSafe Jev 核心参数与架构看板:
- Model ID: typesafe/jev (v1.3)
- Founder: Diogo Almeida (Co-inventor of RLHF & InstructGPT, ex-OpenAI)
- Model Architecture: System 1 (Non-autoregressive Parallel Sampler)
- Input Modality: Multi-modal Text & State context
- Output Format: Strictly Typed (Choice, Score, Boolean) + Calibrated Probability
- Latency Range: 70ms – 500ms (Average ~380ms)
- Input Pricing: $0.042 / 1M Tokens (Vercel Gateway)
- Output Pricing: $0.00 / Free (Zero charge for decision outputs)
``
上线当天,全球最大前端与全栈部署平台 Vercel 便高调宣布:Vercel AI Gateway 已经首发集成 Jev,并在最新的 Vercel AI SDK(v7+)中原生引入了 experimental_evaluate 接口。
开发者只要在前端或后端写下几行简洁的声明式代码,传入一段复杂的上下文,就能瞬间拿到一个类型安全的返回值:
``typescript
// Vercel AI SDK v7+ 原生调用示例
const { choice, score, confidence } = await experimental_evaluate({
model: jev('typesafe/jev'),
prompt: incomingUserLog,
questions: {
threatLevel: choice(['safe', 'suspicious', 'critical']),
isSpam: boolean(),
priorityScore: score({ min: 0, max: 100 })
}
});
``
没有 Markdown 围栏符号,没有额外的 JSON Schema 强制修复插件,没有漫长的前置思考时间。这一设计瞬间引发了全网工程师的疯狂试玩。
---
为什么重要:从慢思考系统 2 到快思考系统 1,卡尼曼法则在 AI 落地
诺贝尔经济学奖得主丹尼尔·卡尼曼在传世著作《思考,快与慢》中,将人类的心智运作划分为两套系统: - 系统 1(快思考):自动、直觉、迅速、无需耗费大量脑力。比如看到一张生气的脸立刻感受到情绪,或者被问及“2+2 等于几”时毫不犹豫脱口而出。 - 系统 2(慢思考):深思熟虑、逻辑严谨、按步骤推演。比如做复杂的数学证明、撰写重构方案、或者在迷宫中寻找最优路径。
回看过去两年的大模型演进,整个硅谷与行业几乎都在盲目追逐“系统 2”的极限。从 OpenAI 的 o1/o3/Astra,到各大厂商的深度思考模式,模型越来越倾向于“沉思几十秒”,打印出几千字的思维链,试图在数学奥赛和学术评测中刷新纪录。
但这种追求带来了一个极其荒谬的现状:我们正在用一辆消耗几万度电、需要思考半分钟的重型卡车,去运送一粒只要 0.1 秒就能做出决定的芝麻。
在真实的工业界,绝大多数需要机器参与的事务,根本用不着复杂的推导: - 这封邮件是不是钓鱼邮件?(Yes / No) - 这篇用户推文属于哪个违规分类?(A / B / C / D) - 这个客服工单的紧急程度打几分?(0–100 分) - 这个函数的入参是否存在 SQL 注入风险?(True / False)
传统方案如果调用 GPT-5.6 或 Claude 3.7,即使强制开启 JSON Mode,也必须经过漫长的自回归排队与解码,每次判断耗时数秒到十几秒,单次账单甚至高达几美分。而在高频并发的真实业务网关面前,这种时延和成本直接导致大模型无法落地。
Jev 的横空出世,正是给大模型生态补上了最关键的一块拼图——一个拥有庞大世界知识,但运转在百毫秒级的纯粹系统 1 模型。
---
显微镜下的三大技术杀手锏:Jev 凭什么既快又准?
为了彻底搞清 Jev 为什么能把性能和成本压缩到不可思议的地步,我们对比了三代判定与分类技术的底层差异:
| 评估维度 | 传统前沿大模型 (GPT-5.6 / Claude) | 经典判别模型 (BERT / DeBERTa) | TypeSafe Jev (系统 1 架构) | 架构代差与实测优势 | | :--- | :--- | :--- | :--- | :--- | | 生成机制 | 自回归逐字生成 (Next-Token) | 编码器分类头 (Encoder + Head) | 非自回归并行采样器 | 告别字符逐步输出,单次推理完成决策收敛 | | 输出格式 | 自由文本字符串,需解析提取 | 离散固化类别 (预设 Label) | 强类型 (Choice / Score / Boolean) | 机器原生契约,物理级杜绝 JSON 崩溃 | | 端到端时延 | 2,000ms – 15,000ms (严重受限) | 50ms – 150ms (极快但无世界知识) | 70ms – 500ms (平均 380ms) | 在保留大模型高阶语义的同时逼近本地反射 | | 概率校准度 | 严重失真 (经常盲目给出 99% 置信度) | 依赖后验缩放 (Platt Scaling) | RLCD 内生校准 (误差 < 1.8%) | 输出置信度具有严格的统计学现实意义 | | 多任务并行 | 串行提问或拼在庞大 Prompt 中 | 只能按单任务专训专用 | 多分支并行评估 (Parallel Evaluation) | 一次状态输入,并发回答十几个分类问题 |
从这个技术架构对比中,可以清晰看出 Jev 具备三大颠覆性的杀手锏:
1. 物理级绝缘格式幻觉:强类型契约
在使用常规大模型时,工程师最痛苦的经历莫过于“JSON 格式损坏”。即便你三令五申“只输出纯 JSON,不要包含任何额外字符”,模型依然会偶尔在开头加上“``json”,或者在结尾少闭合一个花括号,导致下游生产系统直接抛出 JSON.parse` 致命异常崩溃。
Jev 从底层移除了文字生成模块。它的输出层由专门的机器协议约束,只能回传布尔值、枚举索引或数值。它在物理上根本不存在“吐错标点符号”的机制,彻底解除了中间层清洗与重试逻辑。
2. RLCD 算法:从“讨好人类”到“真实概率校准” 在机器学习中,一个致命但常被忽视的概念叫做“校准(Calibration)”。传统经过 RLHF 对齐的大模型,因为人类标注者天生喜欢自信的语气,往往养成了“哪怕自己完全不知道也硬着头皮宣称有 99% 把握”的坏毛病。这种未经校准的置信度在代码自动化中毫无参考价值。 TypeSafe 提出的 RLCD(Reinforcement Learning for Calibrated Decisions)算法,核心在于建立一个惩罚过度自信与盲目猜测的奖惩函数。在 5 万组真实测试集的检验下,Jev 的期望校准误差(ECE)被压制在 1.62% 以内。这意味着:如果 Jev 输出置信度为 0.85,那么在这类样本里,它正确的概率就是精确的 85%。
3. 并行评估采样:一次状态输入,并发解决十道决策题 在传统的 API 调用中,如果你要对一条新闻判断 5 个维度(是否相关、是否广告、属于哪个板块、是否有负面情感、是否涉及上市公司),常规 LLM 必须按顺序生成长串文本,或者在 Prompt 里罗列繁琐的嵌套结构,消耗大量输入与输出 Token。 Jev 采用了并行采样(Parallel Sampler)架构:输入一条上下文,其内部的表征可以同时挂载多个轻量决策头。在一次网络往返内,10 个不同的分类决策几乎零延迟地同步产出,输入 Token 只计费一次,而输出全部免单。
---
开发者实战与落地:三个颠覆认知的现实应用
随着 Jev 在 Vercel 和 TypeSafe 官网上线,全球极客社区在短短 48 小时内涌现出了大量脑洞大开的实测案例:
- 实战案例 01:380 毫秒反恶臭推特浏览器插件(Marcel Pociot 实测):知名开发者 Marcel Pociot 基于 Jev 制作了一款名为“NoBait”的浏览器插件。当用户浏览 X(Twitter)信息流时,每滚过一条推文,插件便在后台静默调用 Jev:“这条内容是否为恶意引战、骗取回复或低俗广告?”Jev 在 380 毫秒内完成布尔值判定。命中为 True 的推文在用户肉眼察觉之前已被自动折叠。传统模型根本无法跟上人类鼠标滚动的刷新频率,而 Jev 让实时语义内容过滤第一次成为了现实。 - 实战案例 02:一秒决策 10 次的马里奥与 7 秒自动化机票预订:游戏与桌面自动化(Computer Use)是检验模型时延的最严苛考场。以往让 GPT-4o 操控屏幕,由于每次点击需要数秒决策,常常在游戏开局就直接撞死在障碍物上。有海外极客利用 Jev 驱动按键判断,直接在模拟器里跑起了《超级马里奥》,达到了每秒 10 次的稳定决策帧率;在另一个网页航班查询测试中,Jev 驱动无头浏览器在 7 秒内连续完成 12 步表单与日历选择,一气呵成。 - 实战案例 03:分级 Agent 架构:高置信静默执行,低置信专家熔断:在复杂的企业自动化流水线中,Jev 成为了最优的“前哨守门人”。开发者构建了一套三级处理路由: - 置信度 > 0.90:属于毫无争议的常规操作,Jev 直接触发下游自动化代码执行(覆盖 80% 的日常请求,成本趋近于零); - 0.70 < 置信度 < 0.90:存在一定歧义,系统将请求上浮给 GPT-5.6 或 Claude 3.7 进行深度思考与二次确认; - 置信度 < 0.70:触发安全熔断,流转至人工坐席后台进行审批。 整套系统在保障 100% 严密合规的前提下,将企业的整体大模型 API 账单直接砍掉了 85% 以上。
---
产业推演:杰文斯悖论降临,智能终将接管所有 if 判断
TypeSafe 给自己的第一个模型取名 Jev,其野心昭然若揭。
1865 年,英国经济学家威廉·斯坦利·杰文斯在其著作《煤炭问题》中提出了一个反直觉的现象:瓦特改良蒸汽机后,单位功率的耗煤量大幅下降。当时人们普遍预测英国的煤炭消费量将大幅萎缩。然而现实情况是,极高的燃煤效率让蒸汽机迅速普及到了纺织、采矿、冶金、铁路等全社会各个角落,英国的煤炭总消费量反而呈现出爆发式指数级激增。
今天,大模型领域正在上演一模一样的一幕。
过去三年,因为大模型 API 昂贵且迟钝,软件工程师在写代码时对 AI 充满了防备:我们小心翼翼地给调用加上缓存,生怕频繁触发超支;我们在大部分流程里依然靠死板的正则表达式、硬编码的 if-else 分支、或者死板的关键词匹配来维系系统运转。
但如果有一天,一次具备全网知识储备的语义理解与高阶决策,只需要 0.042 美元每百万次、380 毫秒即刻返回,且输出彻底免费呢?
工程师的防御心理将瞬间崩溃:
- 为什么还要手写长达几百行的复杂正则去解析奇形怪状的日志?
- 为什么还要设计冗长脆弱的状态机去捕捉用户模糊的操作意图?
- 为什么不直接在代码的核心逻辑里,把每一个条件分支都换成 if (await jev.evaluate(...))?
当语义决策的成本逼近甚至低于传统数据库的一次复杂查询时,软件工程将迎来真正的范式转移。智能不再是一个孤立悬挂在对话框里的聊天伴侣,而是化身为代码世界里随处流淌的基石基础设施。
---