精选解读 · 第 5 页
不追求最快,追求把几条信息拼成一个能用的判断。
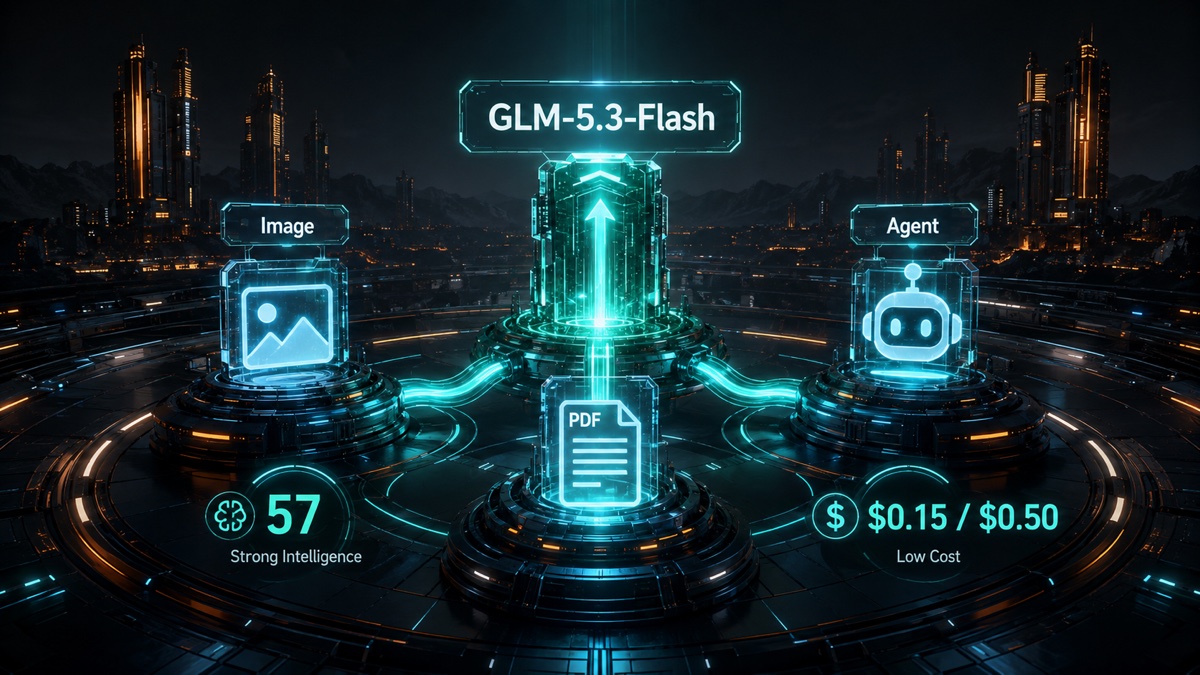
DeepSeek 没掉队,但国产模型已经打成一锅粥:GLM 真正狠的是价格
Artificial Analysis 当前同口径对比中,GLM-5.3-Flash 得 57 分、混合成本约 0.10 美元/百万 token;DeepSeek V4 Pro 得 53 分、约 0.69 美元,V4 Flash 得 52 分、约 0.23 美元但输出接近 119 token/s。DeepSeek 没掉队,GLM 也没有全面碾压;真正的变化是质量、速度、多模态和价格已经分成四条赛道。
适合:正在选择 GLM、DeepSeek、开源多模态模型、Agent API 或控制推理成本的开发者、产品和采购团队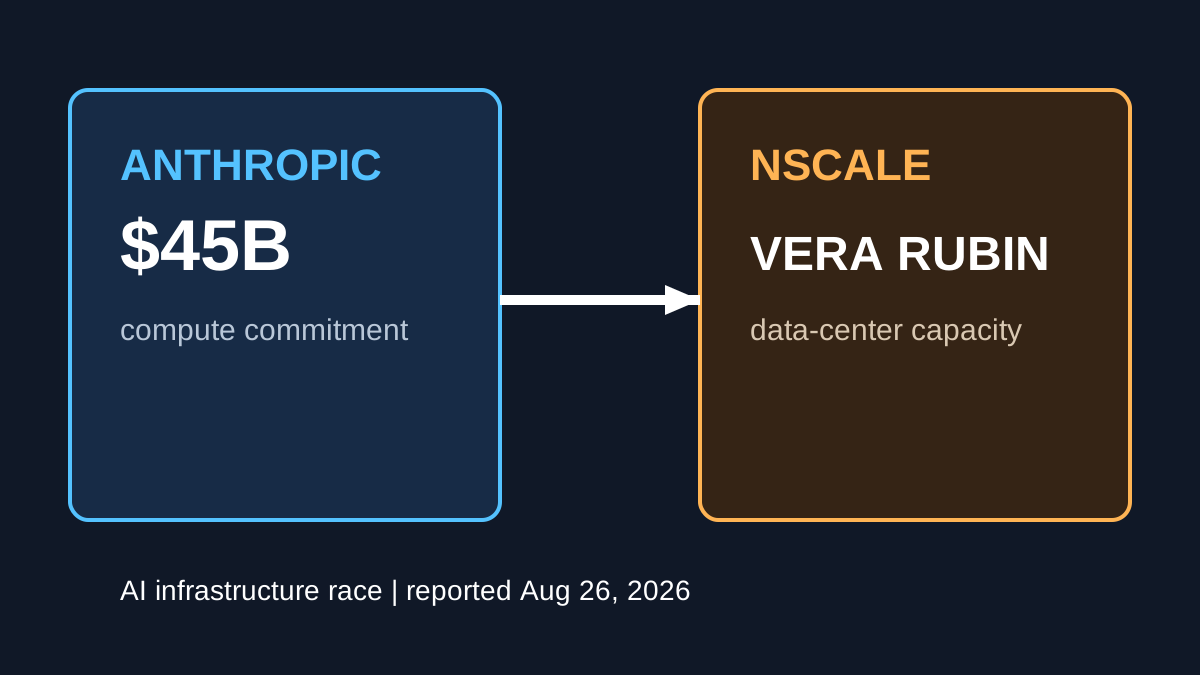
Anthropic 先砸 450 亿美元租算力:Claude 还没赢,机房已经锁到下一代
Reuters、Bloomberg 与 TechCrunch 8 月 26 日报道,Anthropic 将向英国 AI 基础设施公司 Nscale 租用约 450 亿美元算力,并采用 Nvidia Vera Rubin 平台。这个数字来自消息人士而非已公开合同;期限、付款和交付规模仍未知。它说明前沿模型竞争已经从发布会转向电力、GPU 和长期固定成本。
适合:关注 Anthropic、Claude、Nvidia、AI 数据中心、API 成本和模型商业化的开发者、投资者与企业采购团队
“牛来”终于掉马:全网猜了 6 天,竟是智谱 GLM-5.3-Flash
Z.ai 已正式确认 Ox Alpha 就是 GLM-5.3-Flash,并在 Hugging Face 以 MIT License 开放权重。它有 320B 总参数、18B 激活参数,官方 DeepSWE 为 63.4;Bloomberg 称匿名期间用量一度超过 DeepSeek 两倍。但跑分、任务成本和国产芯片承载细节仍主要来自厂商口径。
适合:关注开源模型、Coding Agent、OpenRouter、GLM、国产 AI 芯片和推理成本的开发者、产品与投资者
ChatGPT 终于能“自己上班”了:新邮件一来就醒,登录后继续干活
OpenAI 8 月 25 日同时为 ChatGPT Work 补上两个缺口:用户可在安全表单中登录受支持的网站,然后让云浏览器继续;Gmail、Slack 和 GitHub PR 事件也能直接触发任务。它开始像数字助手,但网站支持、账号资格、人工批准与提示注入风险仍是硬边界。
适合:关注 AI Agent、企业自动化、Zapier/Make/RPA、ChatGPT Work 和浏览器 Agent 的产品、运营与开发团队
OpenAI 用英伟达 GPU 上的模型造芯片,第一代就把 Blackwell 压到了身后
OpenAI 8 月 25 日公布首颗自研推理芯片 Jalapeño 的实测:在 GPT-OSS 120B、DeepSeek R1 和 Kimi K2.5 的固定 8k/1k InferenceX 测试中,其峰值每瓦工作量比英伟达 GB200/GB300 高 1.5–1.9 倍,端到端延迟低 1.7–3.6 倍。结果很强,但芯片仍是工程样片,数字由 OpenAI 提供,Rubin、长上下文和多轮 Agent 负载尚未完整验证。
适合:关注英伟达、OpenAI 基础设施、推理成本、数据中心电力和 AI 芯片供应链的开发者、投资者与产品团队
899美元的 Mac mini,开始被苹果当成“常驻 AI Agent”卖了
Apple 8 月 25 日发布 M6 Mac mini、M5 Pro Mac mini 和 M5 Ultra Mac Studio,首次把 Mac mini 明确写成“always-on agentic computing”设备。M6 Mac mini 起价 899 美元,最高 32GB 统一内存;M5 Ultra Mac Studio 最高 512GB、1.2TB/s 带宽。它更像是在卖一台可以长期运行本地模型和 Agent 的低噪声节点,而不只是更快的桌面电脑。但 Apple 的 AI 性能数字来自自家测试,模型兼容性、持续功耗和真实 Agent 体验仍未知。
适合:想在本地运行大模型、Coding Agent、家庭服务器和隐私敏感工作流的开发者与重度用户
Gemini开始进律所了:Google卖的已经不是聊天机器人
Google Cloud 8 月 25 日推出 Gemini Enterprise for Legal,把 Gemini 定位成面向律所和企业法务的 Agent 工作流产品。RelativityOne 将通过 MCP 接入,Weil 等律所参与早期合作。它说明企业 AI 的竞争正在从“谁的模型会回答”转向“谁能安全接入案件资料、检索、协作和审批”。目前公告证明的是产品与合作关系,不是律师工作已经自动化,也没有公开准确率、返工率或责任分配数据。
适合:律所、企业法务、法律科技开发者,以及关注 MCP、企业 Agent 和数据权限的人
同一个 DeepSeek,换个 Harness 掉 33 分:模型排行榜最容易骗人的地方暴露了
DeepSeek V4 Pro 0813 的官方模型卡在 DeepSeek Harness minimal mode、max reasoning effort 下报告 Terminal-Bench 2.1 为 87.9%;Vals 独立评测同一模型得到 54.68% ±1.50,相差 33.22 个百分点。它又在 Vals 统一 mini-swe-agent 的 SWE-bench Verified 上得到 96.4% ±0.83、排名第二。证据不支持“官方分数造假”或“已经全面追平 Claude”,更准确的结论是:它在边界明确的代码修补任务上很强,而 Agent 排名必须连同 Harness、工具、推理档位与运行规则一起读。
适合:使用 DeepSeek、Claude Code、Codex、Cursor 的开发者,以及需要比较 Coding Agent 能力、成本和排行榜的团队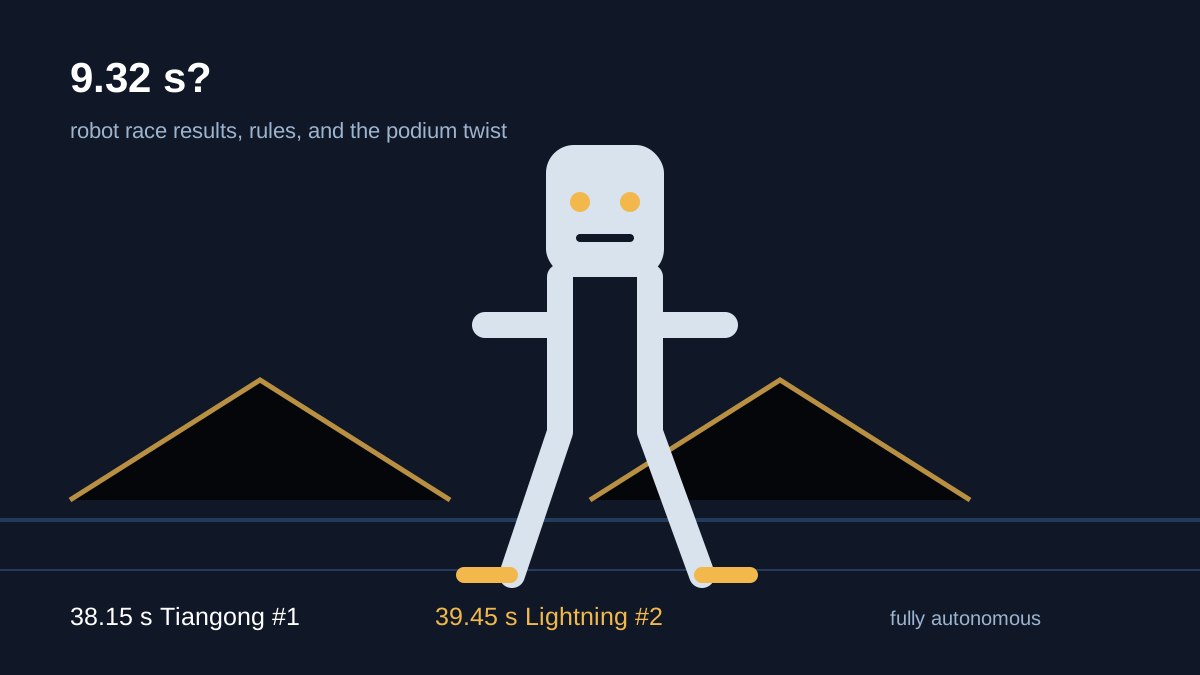
机器人跑进 9 秒,马斯克也转发?但官方成绩表里,荣耀“闪电”连冠军都没拿到
荣耀“闪电”的 9.32 秒百米和 39.45 秒 400 米成绩有荣耀页面与赛事成绩支撑,但“打破人类世界纪录”属于机器人赛事规则下的跨体系比较,不是世界田联认证。官方 400 米大型组成绩表显示,冠军其实是“天工”38.15 秒;马斯克转发目前只能按多家媒体报道呈现,原始 X 帖子仍待公开复核。
适合:关注人形机器人、具身智能、机器人比赛、国产科技品牌和 AI 产业传播的人
Codex 额度缩水真不是错觉:OpenAI 承认有 Bug,连会话标题都在吃额度
OpenAI Codex 负责人 Tibo 公开确认,图片长会话多次 compaction、Computer History 高分位用量和会话标题生成器存在额外 usage 消耗问题,并表示 reset 已向付费账号推进。它补充了此前 sub2api 反欺诈解释:Codex 额度异常可能同时包含风控触发和产品自身 inefficiency,reset 也不等于长期效率已经翻倍。
适合:Codex、ChatGPT Plus/Pro 用户,长期运行 Coding Agent 的开发者与正在比较 AI 编程成本的人
同一个 Claude,30 分变 96 分:真正限制 AI 的可能已经不是模型,而是 Harness
ARC Prize 官方的 model-only 评测中,Claude Opus 5 (High) 在 ARC-AGI-3 得到 30.16%;独立开发者把同一个模型放进 Claude Code 后跑到 24/25、96.2%,另一套 arc-skill 经 ARC replay 验证达到 25/25、183/183 levels、RHAE 100.00。这些不是同一排行榜的可比成绩,却显示在陌生环境探索任务里,Harness、外部记忆、工具和反馈循环可能与模型本身同样重要。
适合:使用 Claude Code、Codex、Cursor、OpenCode 的开发者、Agent 工程师、模型评测与 AI 产品团队
AI 代码越来越强,为什么项目还是做歪?Opus 5 连需求都漏掉 27%
Datafruit 8 月 24 日发布的需求发现 Benchmark 显示,Claude Opus 5 找回 73.1% 的标准需求,仍漏掉约 26.9%;它去重后的 Precision 只有 22.4%,因为输出的需求数量约为标准答案的 1.88 倍。GPT-5.6 Terra 更保守,但 Recall 只有 37.3%。这不是通用准确率,而是一个明确警告:重要 Coding Agent 任务应先澄清需求、确认规格与验收标准,再开始写代码。
适合:使用 Codex、Claude Code、Cursor 和 Vibe Coding 的开发者、产品经理、创业者与企业实施团队