精选解读 · 第 6 页
不追求最快,追求把几条信息拼成一个能用的判断。
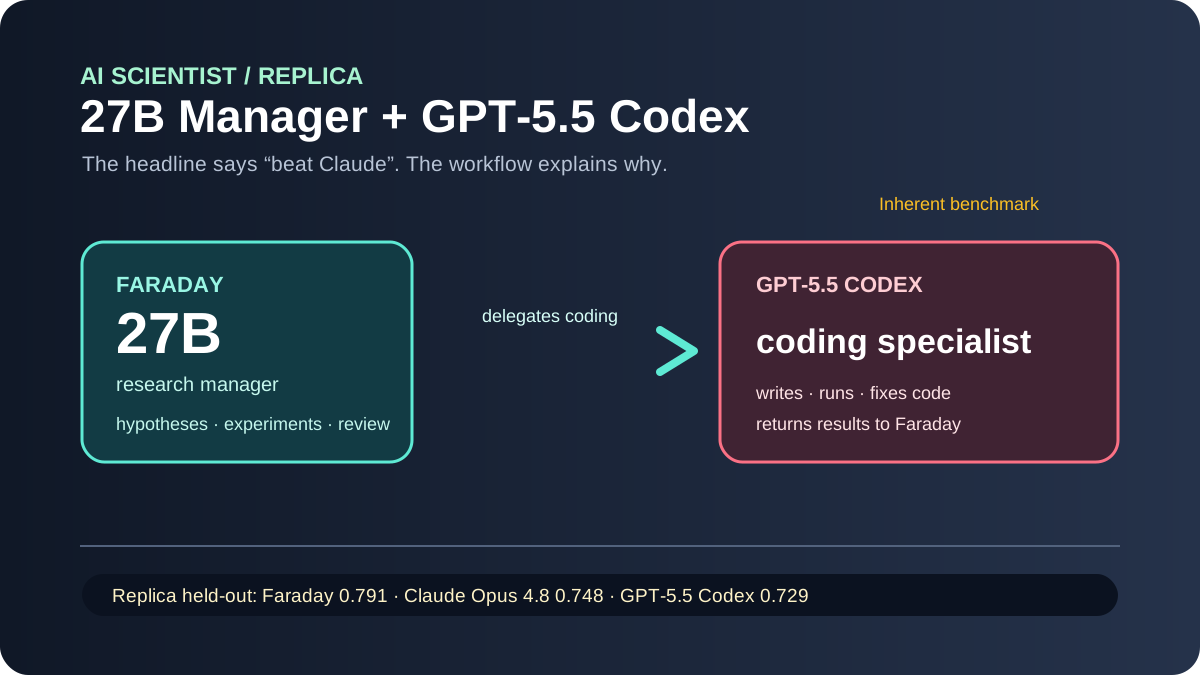
27B小模型“打败Claude”刷屏,但真相更有意思:它把GPT-5.5当下属用了
Inherent 的 Faraday 基于 Qwen3.6-27B,在自建 Replica 论文复现 Benchmark 的 held-out AI-for-science 测试中得到 0.791,高于 Claude Opus 4.8 的 0.748 和 GPT-5.5 Codex 的 0.729。它并非 27B 单挑大模型:Faraday 负责科研判断,会调用 GPT-5.5 Codex 写代码和执行实验。真正值得关注的是 Manager + Specialist 的 Agent 组织方式;Replica 与评分体系仍需外部独立复现。
适合:关注 AI Scientist、科研 Agent、模型路由、长程强化学习和多 Agent 工作流的开发者、研究者与产品团队
Claude 最强模型只拿到 6% Token:企业愿为最后一点性能多付多少?
Ramp 的企业 Token 管理样本显示,Fable 5 在第一个相对完整月份只占 Anthropic Token 的 6%、模型支出的 11.4%,同期 GPT-5.6 Sol 占 OpenAI Token 的 25%。这不能代表整个市场,但 Anthropic 随后推出价格减半、能力接近 Fable 的 Opus 5,并设为 Max 默认模型,说明企业采购正从默认追逐最强,转向比较每个成功任务的总成本。
适合:采购 Claude/OpenAI API、设计 Agent Router、管理模型成本与评估企业 AI ROI 的开发者、产品和财务团队
Anthropic 自己测“AI 读脑术”,结果尴尬了:看模型内部,居然不如直接看聊天记录
Anthropic 的 CHIVE 管线用真实聊天和 Agent 轨迹寻找异常,再通过 5–15 组反事实 Prompt 实验验证解释。在这套可检验任务上,Activation Oracle、Natural-Language Autoencoder 和 Sparse Autoencoder 都没有超过只看聊天记录的 baseline。这个结果不能证明可解释性无用,但说明激活读数目前最多是提示性证据,不能单独当作因果解释。
适合:AI 安全、可解释性、Agent 监控研究者,以及想理解模型“为什么这样做”的开发者
Anthropic 要冲击 2 万亿美元估值,却准备把“反 AI”写进招股书
Anthropic 已秘密提交 S-1 草案,CNBC 引述消息人士称,预计公开的招股书可能把公众对 AI 和数据中心的反弹列为风险因素。公司私募估值接近 1 万亿美元,市场传言 IPO 估值可能达到约 2 万亿美元;但正式文件尚未公开,估值和风险措辞都不能当成已确认结果。
适合:关注 Anthropic、Claude、AI 基础设施、数据中心、电力与科技 IPO 的读者
别只盯 Qwen:这个 35B 本地模型每次只动 3B,有人跑得飞快,也有人被它想崩了
Ornith-1.5-35B-A3B 是一个约 35B 总参数、每个 Token 激活约 3B 参数的 MoE Coding Agent 模型。官方在 Terminal-Bench 2.1、SWE-bench Verified、SWE-bench Pro 和 NL2Repo 上给出了明显高于 Qwen3.6-35B-A3B 的结果;独立 4070 测试的修复 MTP 版本达到约 63.7 tok/s,但这是单机、单作者、特定量化与参数的实验。社区反馈同时出现真实任务一次完成、严重过度思考和大模型长任务崩溃,说明它值得下载对比,却还不能宣布已经全面击败 Qwen 或 DeepSeek。
适合:本地 AI、Coding Agent、llama.cpp/Ollama/LM Studio 用户,以及关心 MoE、量化、MTP 和真实开发效率的开发者
OpenAI 突然给 GPT-5.6 Sol 降价 20%:不是促销,是旗舰模型价格战加速
OpenAI 官方确认 GPT-5.6 Sol API 和符合条件的 Agent credits 未来三个月降价超过 20%,标准短上下文价格为每百万输入 4 美元、输出 20 美元;ChatGPT Pro、Plus 和 Business 订阅不变。它更像争夺开发者工作负载的限时价格战,而不是永久改价。
适合:API 开发者、Coding Agent 团队、企业 AI 采购与正在比较模型成本的人
别再无脑开 Cursor Auto:明天开始,它选什么模型,你可能就按什么模型付钱
Cursor 将从 2026 年 8 月 24 日起调整 Auto 相关计费:Auto Cost 继续按固定的每百万 Token 费率计算,而 Auto Balance 和 Auto Intelligence 按实际路由模型的 API 价格计费。Cursor 同时增加了 Cursor Models 的包含使用量,Pro、Pro Plus、Ultra 的 Other Models 包含额度分别为约 20、70、400 美元。它不是简单的“Auto 涨价”,但 Auto 也不再天然等于最省钱;重度用户应关注实际路由模型、两个额度池和每个成功任务的总成本。
适合:Cursor、Coding Agent、Composer、Grok 和 Claude 重度用户,以及关心 AI 编程成本的开发者与团队
AI 生成的“脑腐”角色火进 Roblox:7 个 prompt 能不能变成版权?
Roblox 热门游戏《Steal a Brainrot》的开发方与代表 Tung Tung Sahur 创作者的法国公司 Mementum Lab 发生诉讼。Do Big 认为 AI 生成材料缺少人类作者,Mementum 则主张角色权益并提出商标诉求;案件仍在审理,不能把任何一方说法当成最终法律结论。
适合:游戏开发者、AI 创作者、IP 运营、短视频团队与关注生成内容版权的人
ChatGPT 开始读你的 iMessage 了:能替你回消息,但这个权限别无脑开
OpenAI 已在 ChatGPT macOS 桌面端推出 Apple Messages 插件,所有套餐可用,但目前只在 Apple Silicon 版本的 Codex 和 ChatGPT Work 中生效。它能搜索、读取 iMessage、SMS、RCS,准备并发送消息;默认会要求确认正文和收件人,但官方也明确警告,按聊天开启“始终允许发送”会移除最后一次人工检查。独立安装测试还显示它需要 Full Disk Access、联系人和自动化权限,因此更适合先用来找消息、总结和写草稿,不适合无脑交出长期发送权。
适合:使用 Apple Silicon Mac 的 ChatGPT/Codex 用户、外贸和客户跟进团队,以及关心 AI 隐私和通信真实性的人
LinkedIn 的“AI 垃圾”按钮被点了 100 万次:用户开始主动反击机器味
LinkedIn 产品负责人称,“看起来像 AI 垃圾内容”按钮上线几周后被点了超过 100 万次,平台还称被其归类为 AI slop 的内容曝光量下降 40%。两项数据都来自 LinkedIn 自己的分类系统,不能直接当成独立审计,但说明用户已经开始主动惩罚机器味。
适合:LinkedIn 内容创作者、外贸与销售团队、求职者、品牌和 AI 写作工具用户
1.65 万亿美元没有消失:AI 数据中心正在把债务搬到你看不见的地方
约 1.65 万亿美元的“隐藏债务”估算,把五大科技巨头的公开债、租赁、采购承诺、担保和项目融资放到了一张表里;它不是已借出的传统债务总额,但揭示了 AI 基建正在把科技公司变成房地产式重资产企业。Meta 与 Blue Owl 的约 273 亿美元 Hyperion 合资、后续约 500 亿美元园区规划,以及 GPU 残值融资,都说明风险没有消失,只是被拆进租约、SPV、私募信贷和未来现金流。
适合:关注 AI 基建、科技股、私募信贷、GPU 供应链和企业财务风险的投资者、开发者与普通用户
DeepSeek 新视觉模型有点狠:一张图只要 384 tokens,但“接近 Opus”别急着信
DeepSeek-V4-Flash-Vision-Exp 把原生图像理解接进了低价 V4 Flash:每张图片最多约 384 个输入 tokens,DeepSeek 自报的部分 Agent Benchmark 贴近或超过 Claude Opus 4.8。但第一批 Hacker News 地标测试出现了把 Wells Cathedral 认成 Salisbury Cathedral 的自信误判,工具截图回传也还没有形成完整闭环。值得拿真实任务做小规模 A/B,不值得现在就把生产视觉模型换掉。
适合:做截图分析、网页 Agent、文档识别、视觉编程与批量图片处理的开发者和产品团队